katsubee에는 올려 둔 문서 안에서 답을 찾아주는 지식 검색(RAG)이 있다. 벡터 검색과 Postgres 키워드 검색을 RRF로 합치는 구조라 하이브리드 검색이라고 생각하고 있었는데, 벤치마크를 돌려 보니 키워드 쪽이 한 번도 일하지 않고 있었다. 찾아서 고친 과정을 적는다.
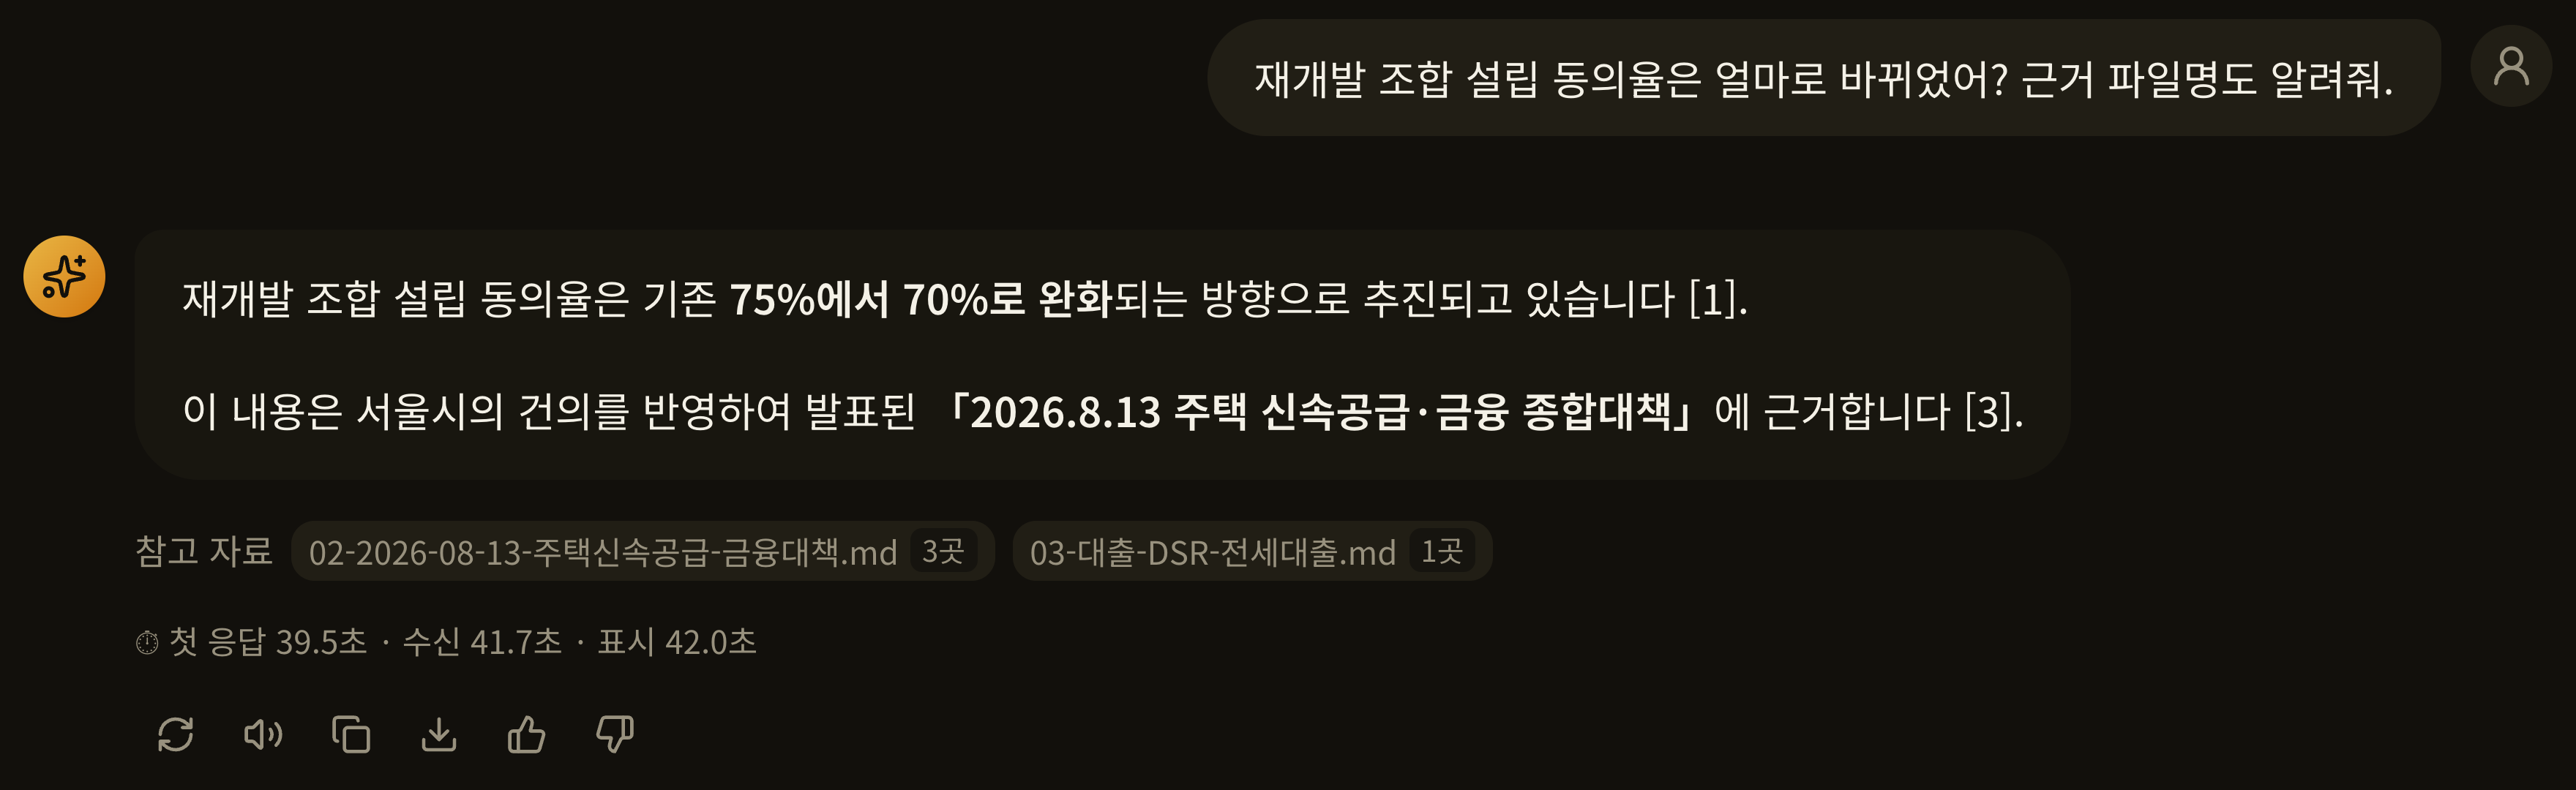
위 화면은 고친 뒤의 모습이다. 부동산 정책 샘플 문서 5개를 올려 두고 "재개발 조합 설립 동의율은 얼마로 바뀌었어?"라고 물었더니 75%에서 70%로 완화된다는 답과 함께 참고 자료 칩에 파일명이 붙었다. 이 질문이 고치기 전에는 키워드 쪽에서 아무것도 못 찾는 질문이었다.
리랭킹부터 붙였다
시작은 리랭킹이었다. 검색 결과 상위 후보를 LLM에게 다시 줄 세우게 하는 기능인데, 크로스인코더를 새로 받지 않고 이미 쓰는 채팅 모델에 후보 번호를 JSON 배열로 달라고 하는 식으로 만들었다. 4초 안에 답이 안 오거나 형식이 깨지면 원래 순서를 그대로 쓴다.
측정은 저장소 docs 문서 65개(청크 430개)를 지식 베이스로 두고, gemma4:26b가 문서에서 뽑아 낸 질문 40개로 했다. 정답 청크가 상위 4개 안에 있으면 맞은 걸로 친다. 리랭킹 없이 10%, 켜면 15%였고 질문 하나당 6.3초가 더 걸렸다. 40개 중 두 개 더 맞힌 걸 효과라고 부르기는 어려워서 기본값은 꺼짐으로 두고 어드민에서만 켜게 했다.
그보다 마음에 걸린 건 리랭킹을 끈 상태의 10%였다. 리랭킹은 이미 뽑힌 후보 안에서 순서만 바꾼다. 정답이 후보에 아예 없으면 소용이 없으니 후보를 뽑는 쪽을 의심하기 시작했다.
키워드 검색이 40개 질문 모두에서 0건
검색은 두 갈래다. 벡터 쪽은 질문을 임베딩해서 코사인 거리로 가까운 청크를 뽑고, 키워드 쪽은 Postgres tsvector로 단어가 맞는 청크를 ts_rank 순으로 뽑는다. 두 순위는 RRF로 합친다. 각 순위에서 청크가 받는 점수는 1/(60+순위)이고, 두 갈래에서 받은 점수를 더한다. 점수 스케일을 맞출 필요가 없어서 편한데, 한쪽이 비어 있어도 에러 없이 나머지 한쪽 순위로 결과가 나온다. 이번에 키워드 쪽이 비어 있는 걸 늦게 안 이유다.
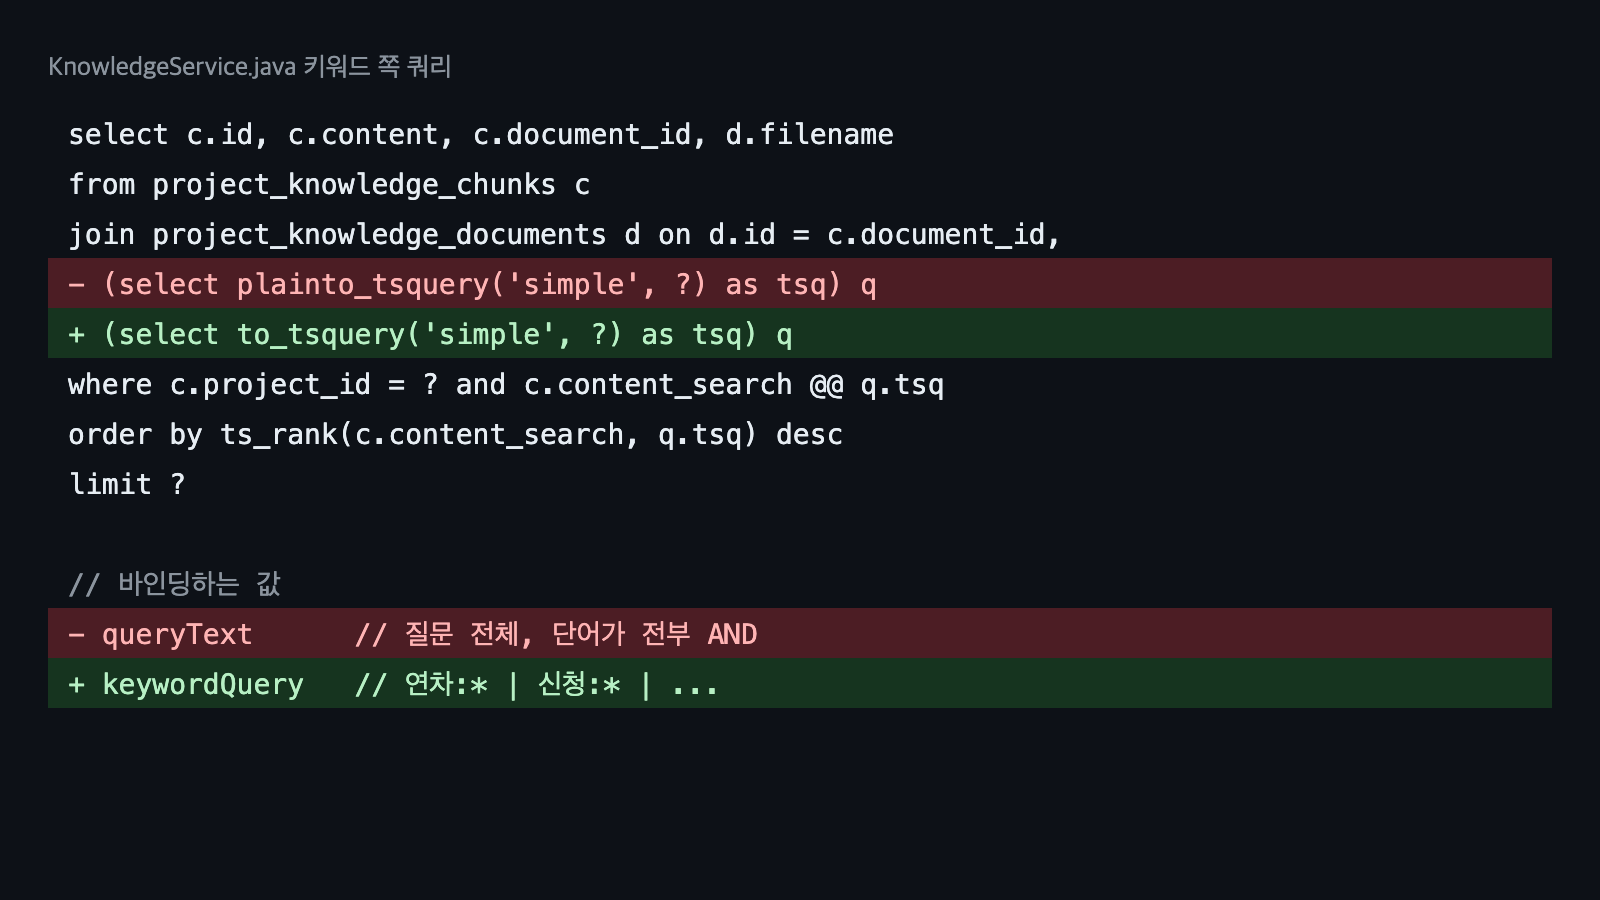
벤치마크에 키워드 갈래만 따로 돌려 보는 코드를 넣었더니 40개 질문 전부 결과 없음이었다. 범인은 이 쿼리였다.
AND로 묶여 0건이 된 이유
plainto_tsquery는 질문에 들어 있는 단어를 전부 AND로 묶는다. 이걸 눈으로 확인하려고 DB에서 직접 돌려 봤다. 위 질문을 넣으면 '재개발' & '조합' & '설립' & '동의율은' & '얼마로' & '바뀌었어'가 된다. 'simple' 설정은 형태소 분석을 하지 않아서 "동의율은"과 문서의 "동의율"이 다른 단어로 취급되고, "얼마로"나 "바뀌었어" 같은 말은 문서에 있을 리가 없다.
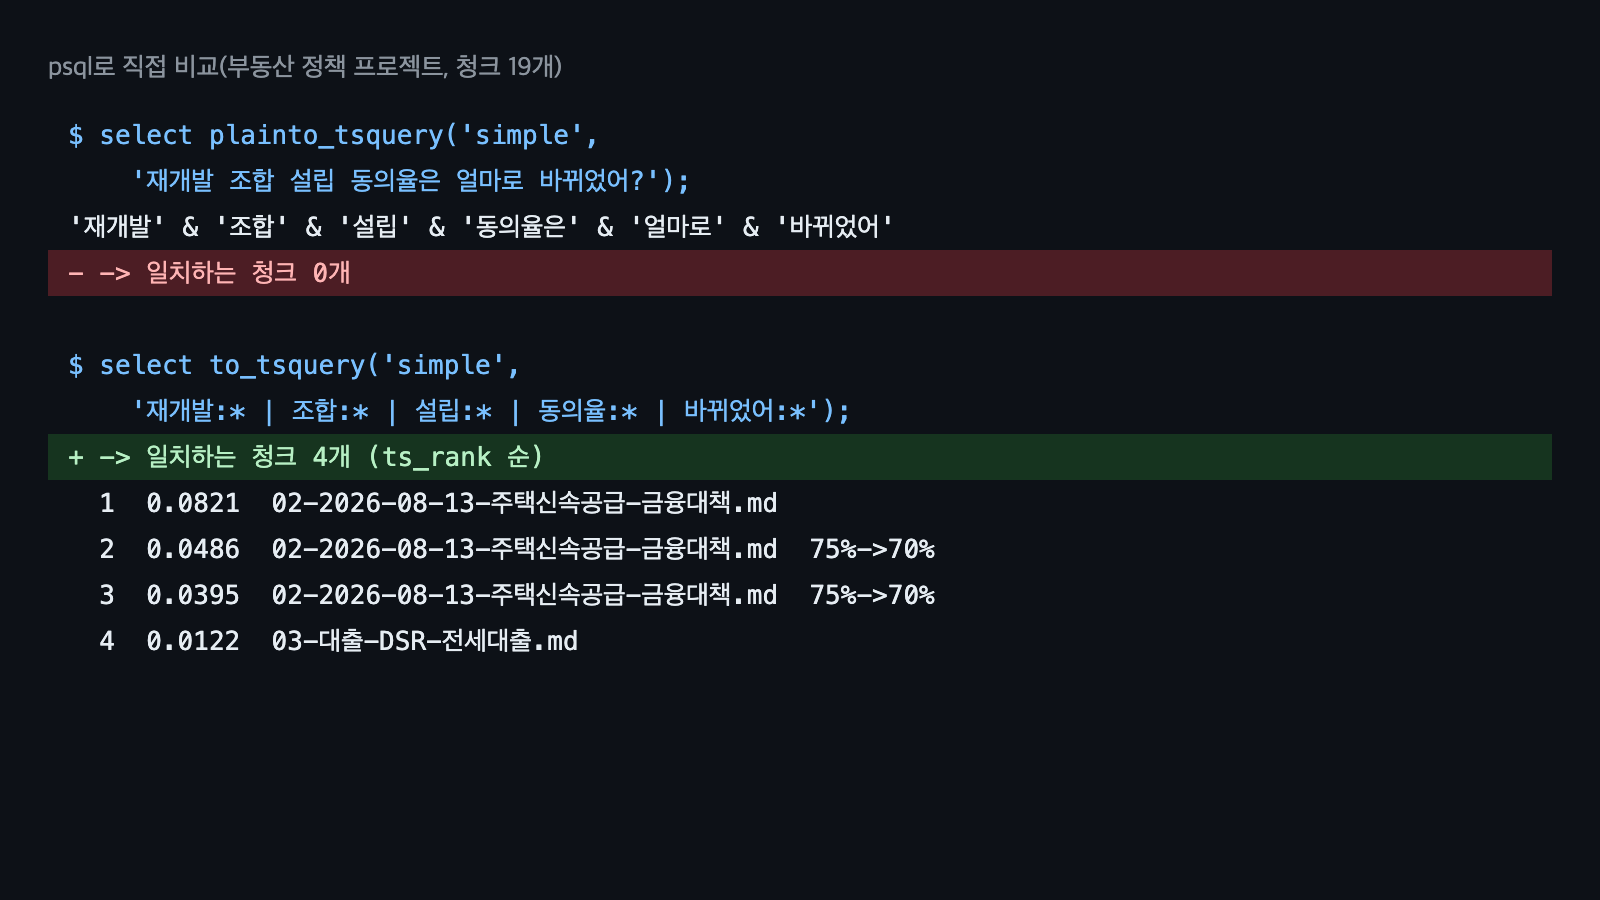
위 그림의 위쪽이 기존 쿼리 결과다. 청크 19개짜리 작은 프로젝트에서 0개였다. 키워드 검색은 검색어 두세 개를 넣는 사람을 기준으로 만든 도구인데 katsubee에서는 다들 문장으로 묻는다.
핵심어만 뽑아서 OR로 잇기
고친 방식은 단순하다. 질문을 글자와 숫자가 아닌 문자 기준으로 쪼개고, 조사를 떼고, 어떻게나 알려줘 같은 의문사와 요청 표현, 한 글자짜리를 버린다. 중복을 지우고 12개까지만 남긴 뒤 OR로 잇고 각 단어 뒤에 :*를 붙여 to_tsquery에 넘긴다. 위 그림 아래쪽이 그 결과로, 같은 질문에서 청크 4개가 잡혔다. 정답이 들어 있는 청크(75%에서 70%)는 키워드 순위로 2위와 3위였다. 1위는 같은 문서의 주의 사항 청크였다. 최종 순서는 여기에 벡터 순위를 RRF로 더해서 정해진다.
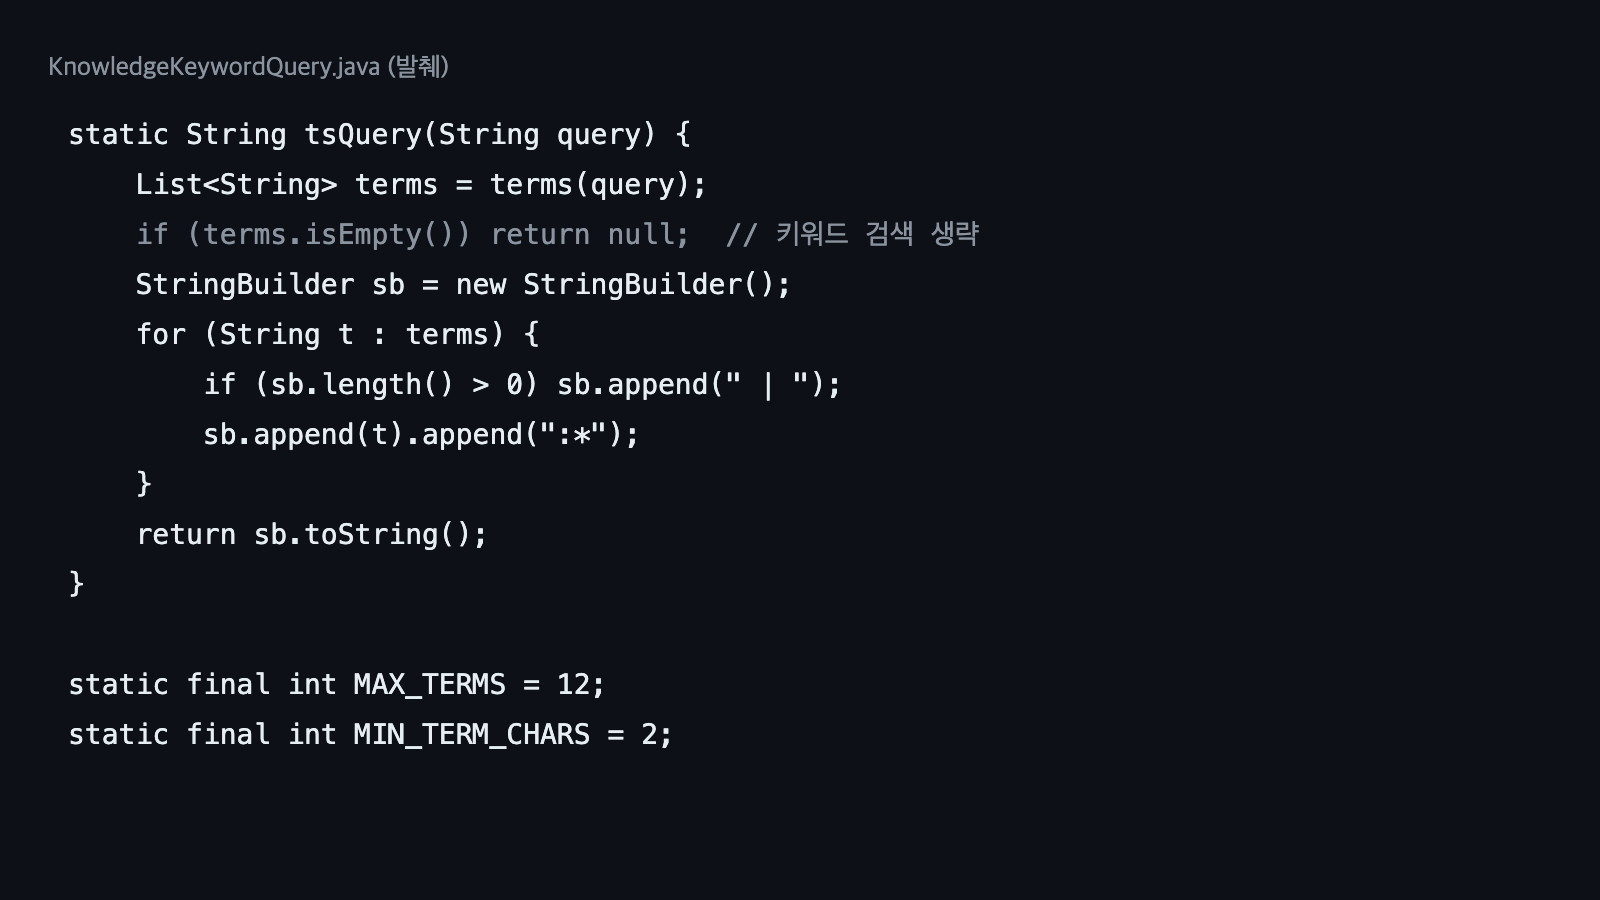
조사 제거는 일부러 거칠게 했다. 형태소 분석기 없이 어미 목록으로 자르기 때문에 이 질문에서도 "바뀌었어"는 그대로 남았다. 테스트 케이스에는 와이파이가 와이파로 잘리는 경우도 있는데, :* 접두 매칭이 뒤를 받아 주니 검색에는 지장이 없다. 반대로 못 떼어 낸 말은 그냥 매칭이 안 될 뿐이고, OR라서 다른 핵심어가 있으면 문제가 되지 않는다. 입력에서 글자와 숫자만 남기기 때문에 tsquery 연산자 문자가 끼어들 틈이 없다는 점도 덤이었다. 핵심어가 하나도 안 남는 질문은 키워드 검색을 건너뛰고 벡터 검색만 쓴다.
테스트로 못 박은 것
이 변환은 순수 함수라서 단위 테스트로 고정하기 쉬웠다. 노트북이 뭐야는 노트북 하나만 남고, 의문사만 있는 입력은 null을 돌려줘서 키워드 검색을 건너뛴다. 같은 단어를 반복해도 하나로 줄고, 입력이 길어도 12개에서 끊긴다. tsquery 연산자를 섞은 악의적인 입력은 결과가 글자와 숫자, 그리고 ' | '와 ':*'로만 이뤄지는지 검사한다.
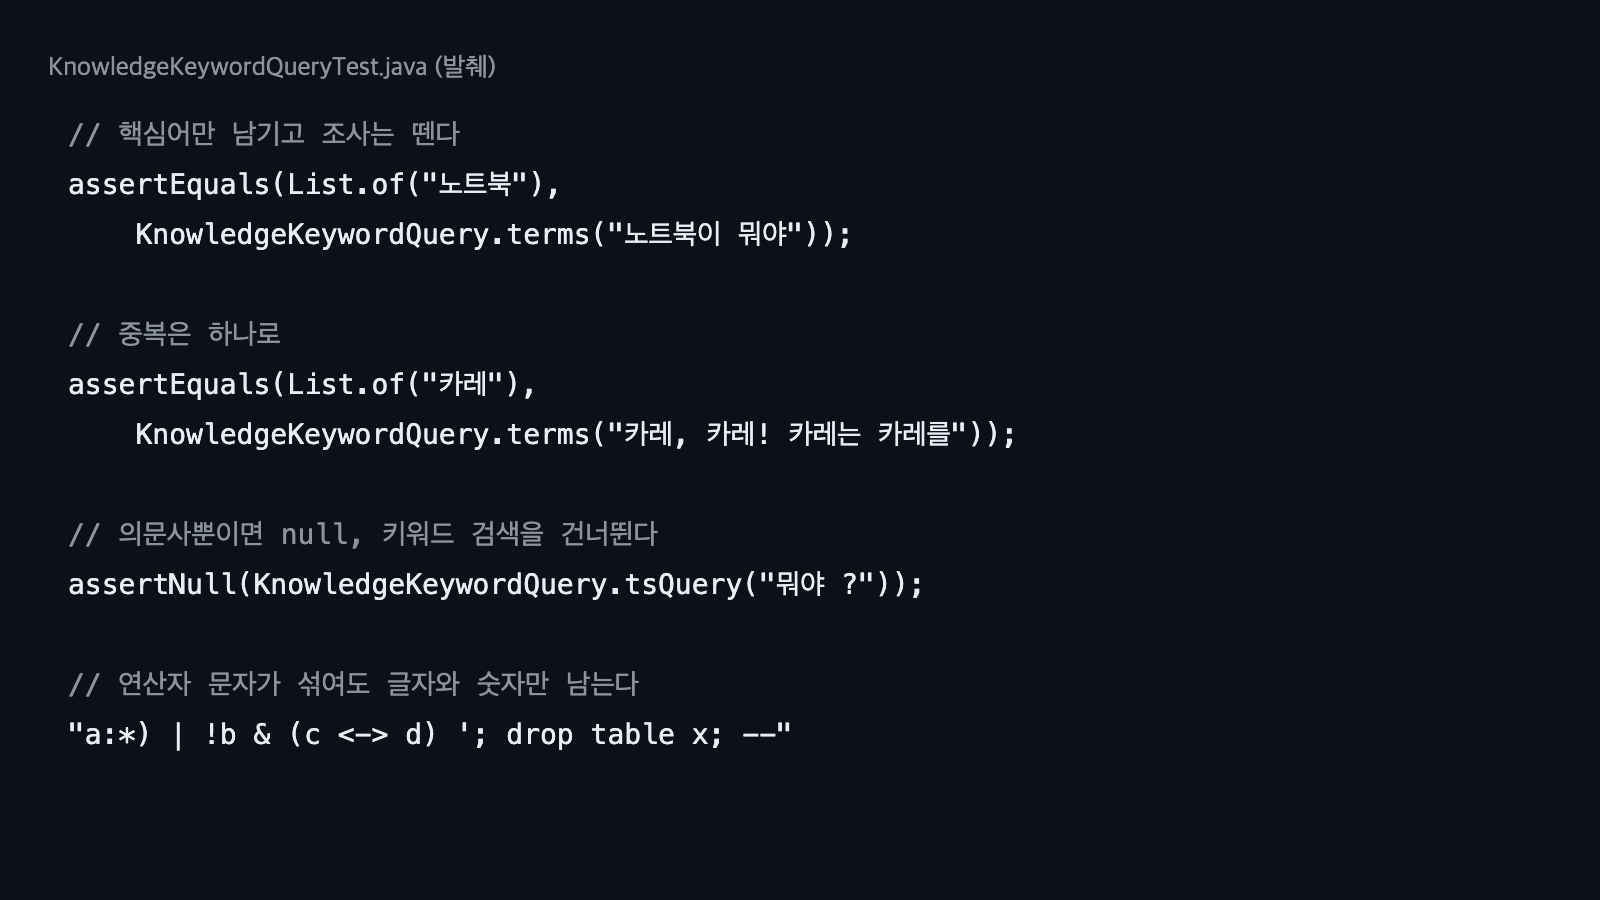
DB를 붙인 통합 테스트도 네 개 추가했다. 자연어 질문이 실제로 청크에 걸리는지, 접두 매칭이 동작하는지, OR 의미가 맞는지, 불용어만 있는 질문이 빈 결과를 내는지를 본다. 이 테스트에 일부러 버그를 심어 보는 변이 6종 중 5종이 검출됐다. 못 잡은 한 종류는 null 질의를 DB가 빈 결과로 처리해서 동작이 같아지는 경우라 어차피 구분할 수 없는 변이였다.
결과
벤치마크로 돌아와서, 같은 질문 40개와 같은 코퍼스(문서 66개, 청크 435개)로 키워드 방식 세 가지를 비교했다. 아래는 정답 청크가 키워드 결과 상위 12개 안에 들어온 질문 수다.
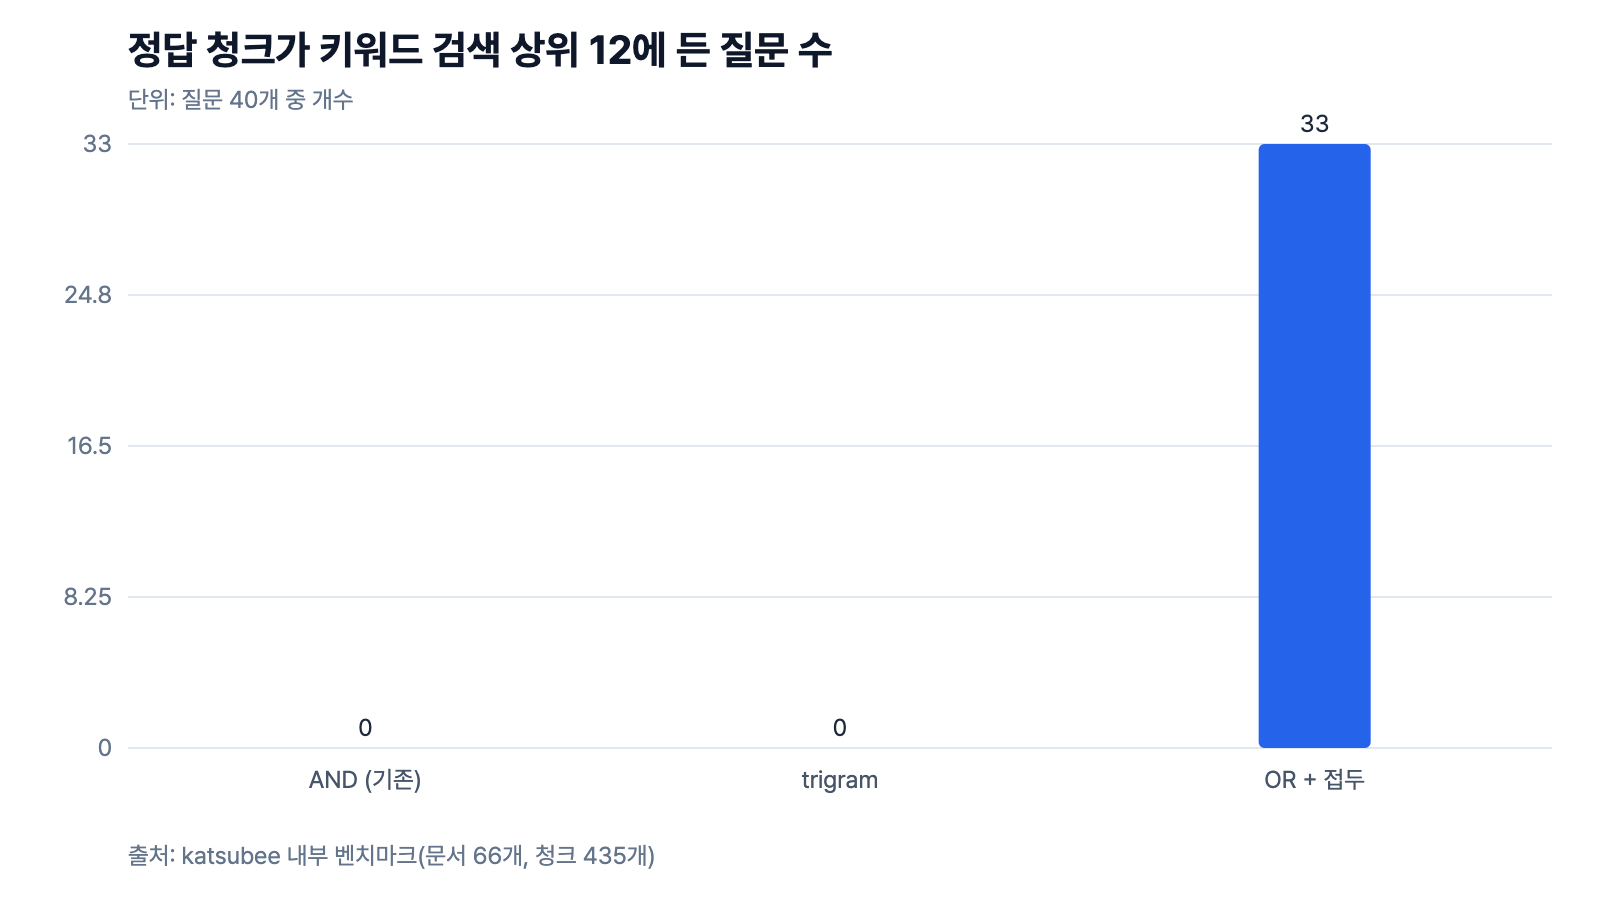
키워드 방식 세 가지 비교
기존 AND는 0개, OR와 접두 매칭은 33개다. trigram(word_similarity)도 해 봤는데 긴 질문 전체를 청크와 비교하는 방식이라 이쪽도 0개여서 접었다.
전체 흐름으로 보면 리랭킹 없이 hit@4가 47.5%, hit@1이 17.5%이고 질문당 64ms다. 리랭킹을 켜면 hit@4가 72.5%, hit@1이 70%, MRR이 0.708로 오르고 시간은 6.4초가 된다.
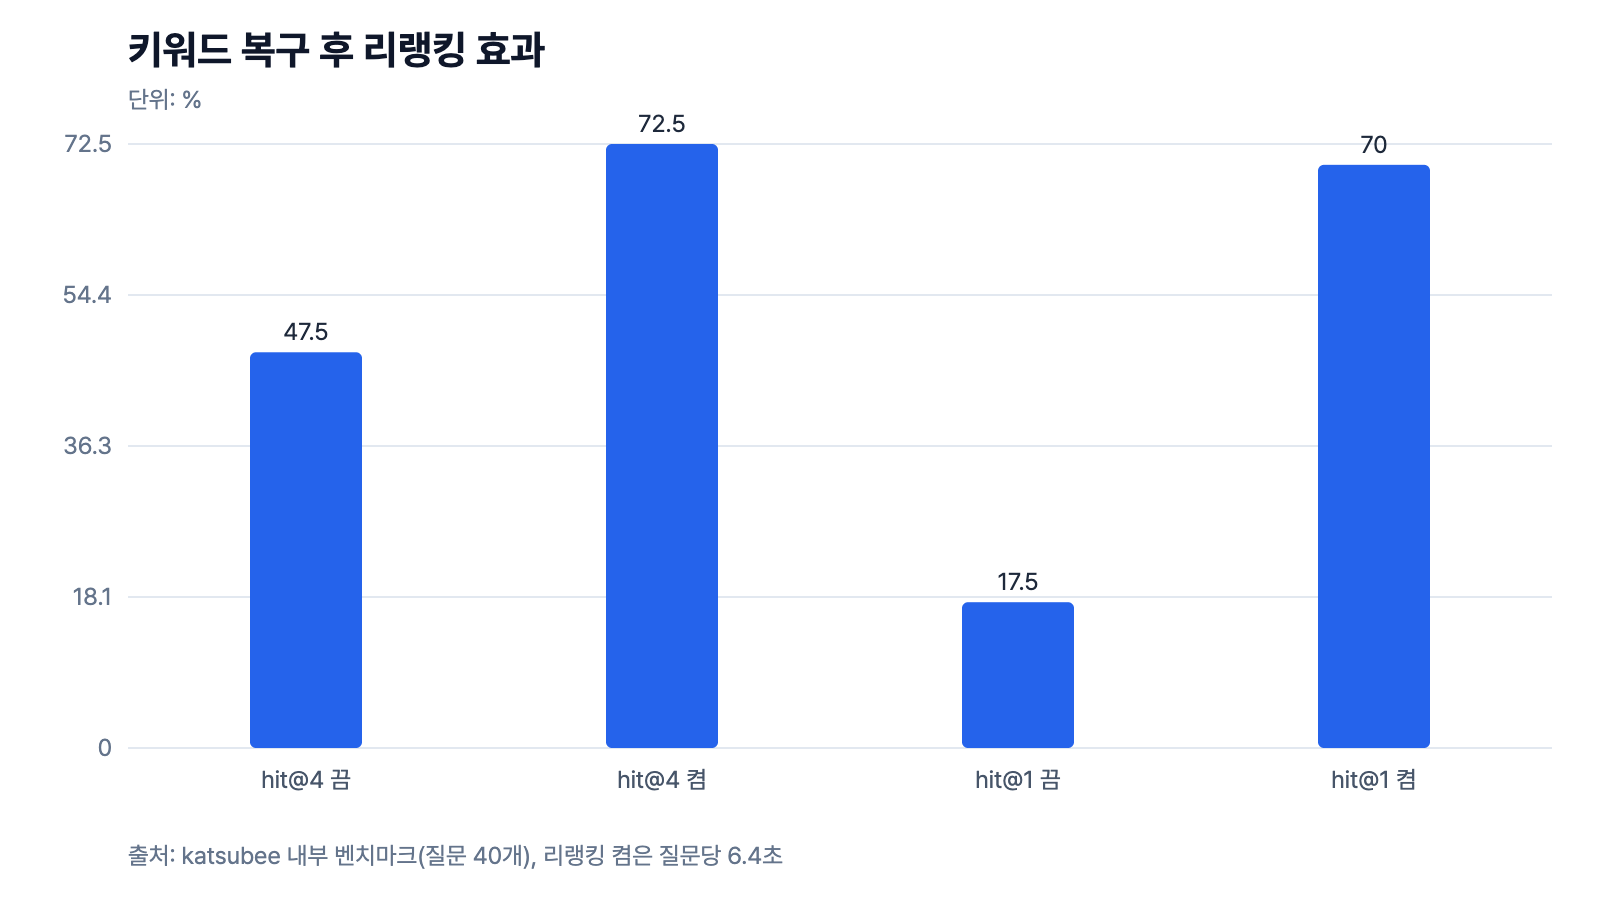
리랭킹은 기본값 꺼짐 유지
후보가 제대로 들어오니 똑같은 리랭킹이 갑자기 제 몫을 한다. 6.4초는 여전히 부담이라 기본값은 꺼짐 그대로다. 키워드 쪽만 고쳐도 지연 없이 47.5%까지 올라가니 순서를 만지기 전에 먼저 했어야 할 일이 이쪽이었다.
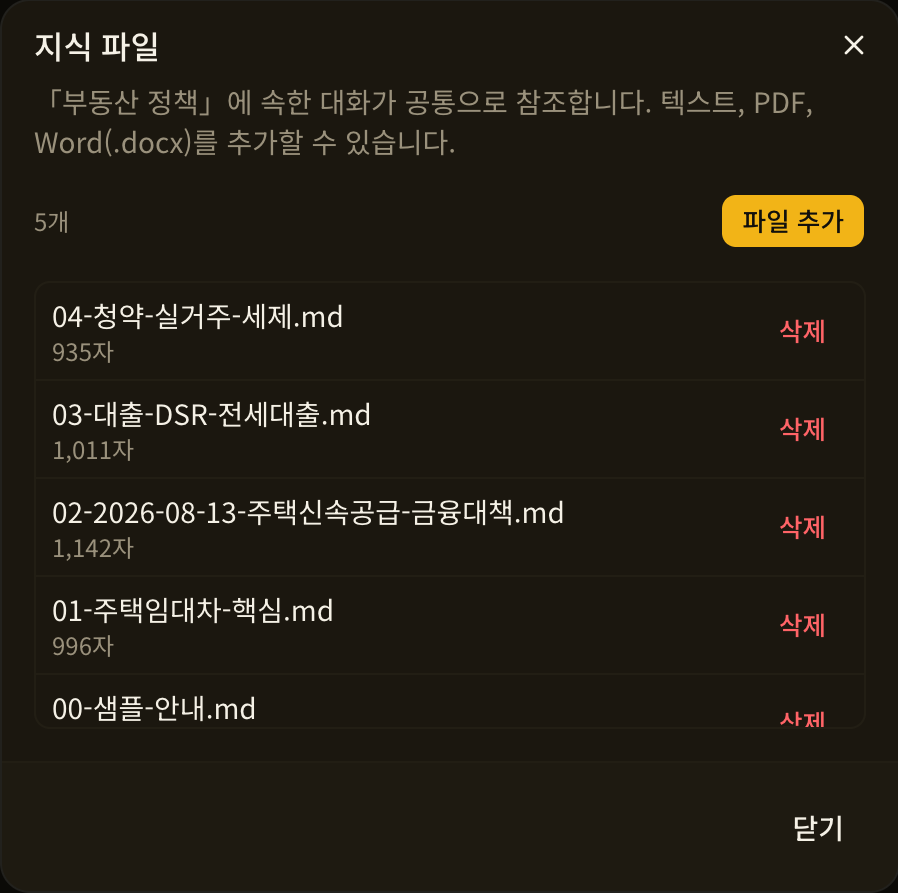
위는 예시로 쓴 부동산 정책 프로젝트의 지식 파일 목록이다. 시연용 샘플 문서라 법령 원문이 아니다.
숫자를 읽을 때
질문 세트를 새로 뽑았기 때문에 처음의 10%와 47.5%를 그대로 비교하면 안 된다. 믿을 수 있는 건 한 번의 실행 안에서 나란히 잰 0/40 대 33/40이다. 코퍼스가 우리 저장소 문서이고 질문도 LLM이 만든 것이라 다른 데서는 수치가 달라질 것이다. 표본이 40개라 47.5%나 72.5% 같은 중간 지표는 흔들릴 수 있고, 33/40이니 7개는 여전히 놓친다. 스크린샷과 psql 예시는 샘플 프로젝트 하나에서 한 번 해 본 것이라 성능 근거가 아니라 동작을 보여 주는 용도다.
한쪽이 놀고 있어도 하이브리드라는 이름은 그대로 붙어 있다. 두 갈래를 따로 재는 진단은 벤치마크에 남겨 뒀다.
'개발이야기 > RAG' 카테고리의 다른 글
| katsubee RAG 리랭킹, 기본 꺼짐과 운영 켜짐 (0) | 2026.10.26 |
|---|---|
| katsubee RAG 로우데이터 수집, 198건 분석 (0) | 2026.10.26 |

