클라우드 품질 루틴 개선: 앵커 질문 5개와 고정 채점표로 일간 추이 비교하기
- TB-261에서 공개 채팅 주소로 게스트 질문을 보내는 클라우드 루틴 3개(일간, 주간, 월간)를 만들었습니다.
- TB-270에서는 매일 같은 앵커 질문 5개를 고정하고 나머지 7개만 무작위로 뽑으며, 채점표도 고정했습니다.
- 표본이 작아 일간 평균이 ±0.3 안에서 움직이면 잡음으로 봅니다. 앵커를 바꾸면 추이가 끊기는 문제는 해결하지 못했습니다.
katsubee를 개발하며 남기는 기록입니다. 이번에는 클라우드에서 돌리는 품질 점검 루틴을 TB-261로 만든 뒤, 비교가 되지 않는다는 문제를 TB-270에서 손본 과정을 적습니다.
TB-261에서 만든 클라우드 루틴 세 개
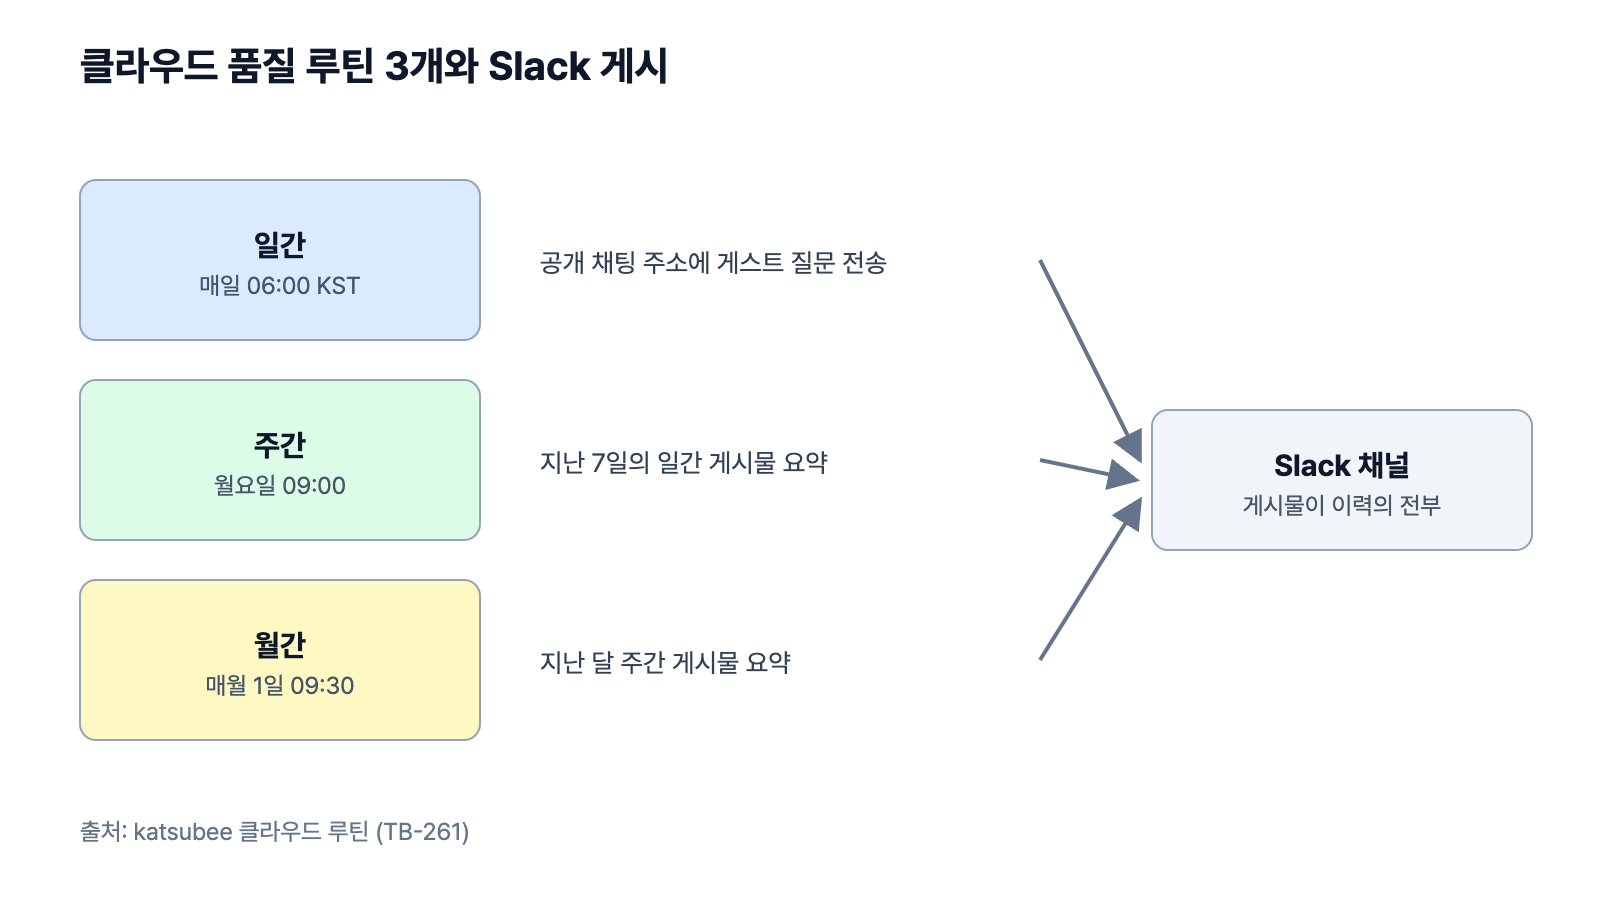
TB-261은 Anthropic 클라우드 루틴 3개를 만드는 작업이었습니다. 일간 루틴은 매일 06:00(KST)에 공개 주소로 게스트 질문을 보냅니다. 주간 루틴은 월요일 09:00에 지난 7일 동안의 일간 게시물을 읽고 요약합니다. 월간 루틴은 매월 1일 09:30에 지난 달 주간 게시물을 요약합니다. 세 루틴의 결과는 모두 Slack 채널에 올라갑니다.
클라우드 세션에서는 저장소와 로컬 Ollama에 접근할 수 없습니다. 그래서 LLM이 해야 하는 판정은 루틴을 실행하는 Claude가 맡습니다. 스크립트가 하는 일은 질문을 보내는 것과 자동 검사까지입니다.
무작위 12개 질문이 만든 비교 불능
첫 버전의 일간 루틴은 질문 풀에서 12개를 무작위로 뽑았습니다. 풀 전체를 고르게 훑는다는 장점은 있었습니다. 문제는 날짜 사이의 비교였습니다.
오늘 평균이 어제보다 낮게 나왔다고 해 봅시다. 질문이 어려웠던 날인지, 답변이 실제로 나빠진 날인지 알 방법이 없습니다. 질문 구성이 매번 달라지니 숫자의 변화에서 원인을 가려낼 수 없었습니다.
판정을 실행 때마다 Claude가 하는 구조라는 점도 마음에 걸렸습니다. 질문이 달라지는 데다 채점 기준마저 흔들릴 수 있다면, 평균 점수는 추이를 읽는 자료로 쓰기 어렵습니다. TB-270은 이 두 가지를 겨냥했습니다.
앵커 질문 5개와 무작위 7개의 구성
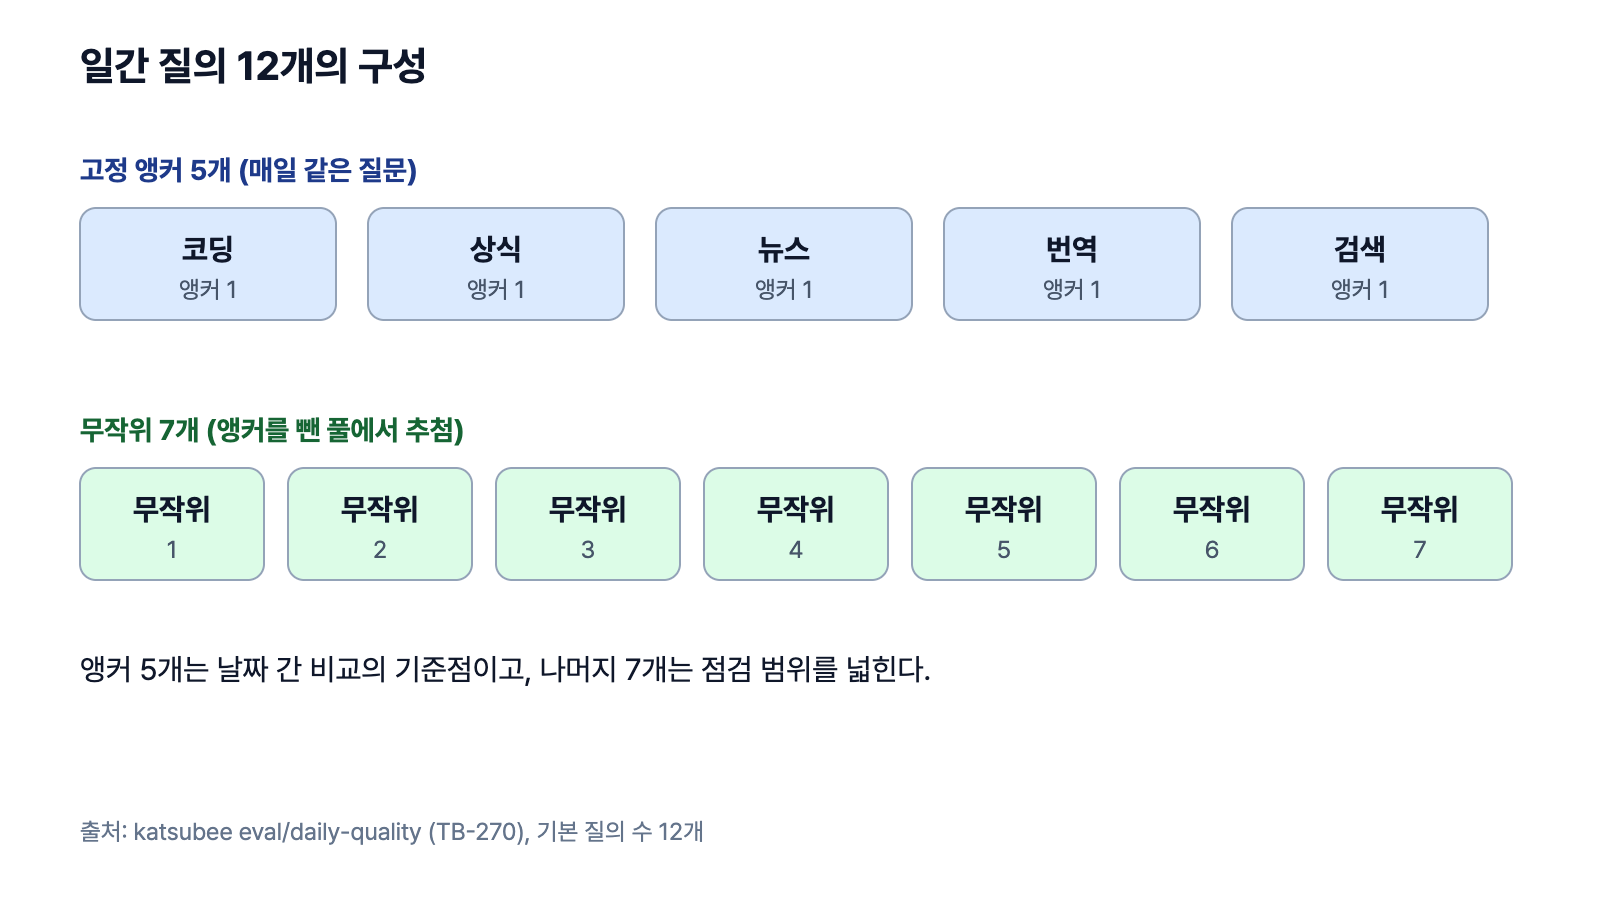
TB-270에서 eval/daily-quality/anchors.json을 추가했습니다. 코딩, 상식, 뉴스, 번역, 검색 다섯 카테고리에 질문을 하나씩 고정한 파일입니다. 날짜가 바뀌어도 이 5개는 같은 문장으로 나가므로 날짜 사이를 비교하는 기준점이 됩니다.
probe.py daily에는 --anchors 옵션을 붙였습니다. 기본값은 5이고 0을 주면 앵커를 쓰지 않습니다. 출력 JSON의 항목마다 anchor 필드가 있어서, 채점하는 쪽은 앵커 질문과 무작위 질문을 구분해서 읽을 수 있습니다.
anchors = [(c, ANCHORS[c]) for c in cats if c in ANCHORS][: a.anchors]
picks = list(anchors)
for c in cats:
 if not any(c == pc for pc, _ in picks):
 picks.append((c, rnd.choice(POOL[c])))
남은 자리를 채우는 방식
앵커를 먼저 넣습니다. 앵커가 없는 카테고리가 있으면 그 카테고리의 풀에서 하나를 뽑습니다. 그래도 비는 자리는 앵커를 제외한 풀을 섞어 채웁니다. 기본 질의 수가 12개이므로 결과는 앵커 5개에 무작위 7개입니다.
다른 선택지와 비교
검토한 방법은 두 가지였습니다. 하나는 앵커 없이 풀만 키우는 것인데, 질문이 늘어도 날짜 간 비교 문제는 그대로입니다. 다른 하나는 질문 12개를 전부 고정하는 것입니다. 비교는 쉬워지지만 같은 질문만 반복하게 되어 점검 범위가 좁아집니다. 소수만 고정하고 나머지는 흔들어서 비교와 범위를 각각 다른 질문에 맡기는 절충안을 골랐습니다.
채점 기준을 런북에 고정하기
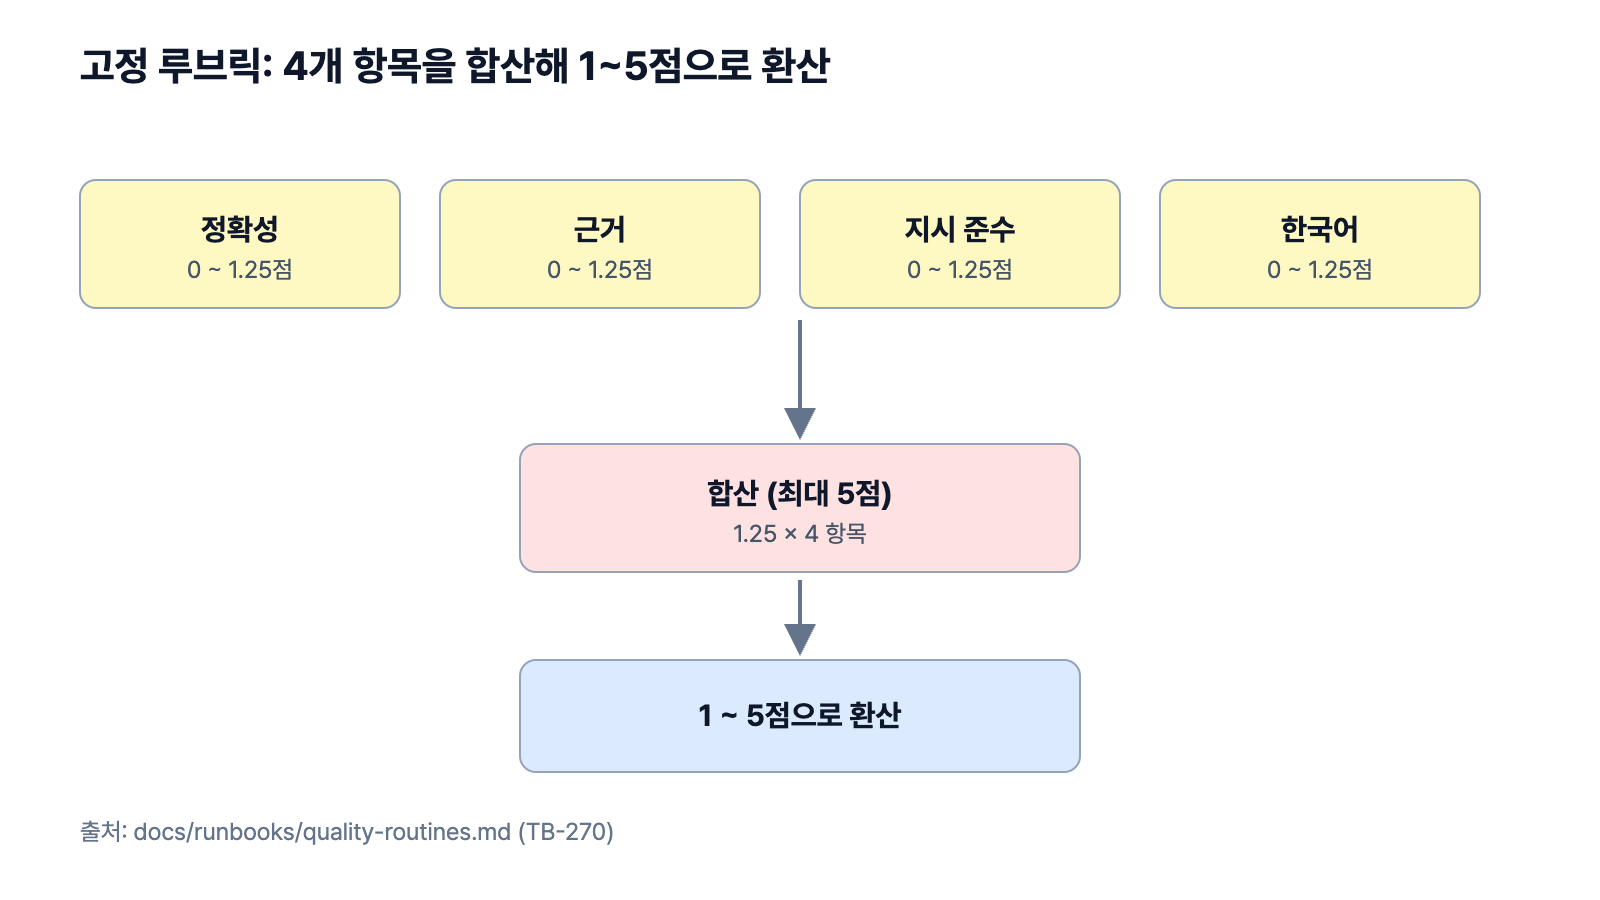
루브릭은 런북에 못 박았습니다. 정확성, 근거, 지시 준수, 한국어 네 항목을 각각 0~1.25점으로 매기고 합산한 값을 1~5점으로 환산합니다. 판정하는 Claude 모델이 매번 같다는 보장이 없습니다. 모델을 고정할 수 없으니 항목의 정의라도 고정해 두기로 했습니다.
카테고리별로 달라지는 자동 검사도 있습니다. 뉴스와 검색 질문은 답변에 웹 출처가 붙었는지 확인합니다. 번역 카테고리는 한글 비율 검사를 0으로 풀어 줍니다. 영어로 번역한 문장은 한글이 적을 수밖에 없는데, 그 이유로 감점되면 안 되기 때문입니다.
운영 규칙과 부하 테스트 안전장치
일간 결과는 카테고리별로 묶은 아티팩트로 발행하고, Slack 게시물에 그 링크를 겁니다. 이력을 담아 두는 저장소는 따로 없어서 Slack 게시물이 곧 기록입니다. 주간과 월간 루틴이 앞선 게시물을 읽어 요약하므로, 게시물의 DATA: 줄 형식은 바꾸면 안 됩니다.
점수를 읽는 기준도 정했습니다. 변화는 앵커 점수와 주간 평균으로 판단합니다. 일간 평균이 ±0.3 안에서 움직이는 정도는 잡음으로 봅니다. 하루 12건, 한 번 측정한 값이라 그보다 예민하게 읽을 근거가 없기 때문입니다. 3점 이하를 받은 질문은 eval/chat-quality/cases.json 골든셋 후보로 올리고, 주간 요약에 목록으로 싣습니다.
간헐 부하 테스트
같은 스크립트에는 간헐적으로 도는 부하 테스트도 들어 있습니다. burst-due가 날짜 문자열의 해시를 이용해 약 25% 확률로 부하 테스트일을 정하고, 월요일은 제외합니다. 부하는 동시 5건, 총 30건입니다. 오류율이 20% 이상이거나 응답이 60초를 넘으면 남은 요청을 보내지 않고 멈춥니다. 운영 서버를 실제 사용자와 함께 쓰고 있어서 넣은 안전장치입니다.
첫 실행 실패와 사전 조건
TB-261 티켓에는 가짜 서버로 daily와 burst 동작만 확인했다고 적혀 있었습니다. 클라우드에서 운영 주소까지 닿는지는 미검증 상태였습니다. 2026-10-20의 첫 실행은 실제로 실패했습니다. 루틴 실행 환경의 네트워크 정책에서 대상 도메인이 허용 목록에 빠져 있었고, 에이전트 프록시가 연결을 거부했습니다.
원인을 가르는 방법은 런북에 적어 두었습니다. 서버가 거부했다면 HTTP 상태 코드가 돌아옵니다. 프록시가 막았다면 curl이 상태 코드 없이 끝납니다.
이 실패로 사전 조건 두 가지가 문서에 추가되었습니다. 하나는 허용 도메인 등록입니다. 다른 하나는 probe.py를 origin에 먼저 올려 두는 것인데, 클라우드는 로컬 main을 볼 수 없기 때문입니다.
TB-270은 PR #32로 머지되었습니다. 티켓에는 머지 이후 루틴이 origin/main의 probe.py를 사용한다고 적었습니다. 앵커를 도입한 뒤 점수 추이가 어떻게 움직였는지는 이 글에 쓰지 않았습니다. 확인한 수치가 아직 없습니다.
한계와 남은 과제
앵커가 있으면 추이는 볼 수 있습니다. 다만 앵커 5개가 전체 품질을 대표한다고 말하기는 어렵습니다. 앵커를 바꾸는 순간 그 지점에서 추이가 끊깁니다. 바꾸더라도 새 기준선이 쌓일 때까지는 비교를 미뤄야 합니다.
루브릭을 고정해도 판정은 여전히 LLM이 합니다. 같은 답변이 다른 날에는 다른 점수를 받을 수 있고, 그 편차를 아직 수치로 재지 못했습니다. 뉴스와 검색 질문은 외부 상황에 따라 정답이 달라지므로 앵커로서 안정적인지도 의문입니다.
남은 과제는 두 가지입니다. 앵커 점수가 며칠 쌓인 뒤 실제 데이터로 잡음 폭을 다시 정하는 일, 그리고 3점 이하 후보가 골든셋으로 실제 승격되는 흐름을 점검하는 일입니다.