RAG 검색 품질 로우데이터 198건 집계, 키워드·벡터·RRF·리랭킹 단계별 정답 순위
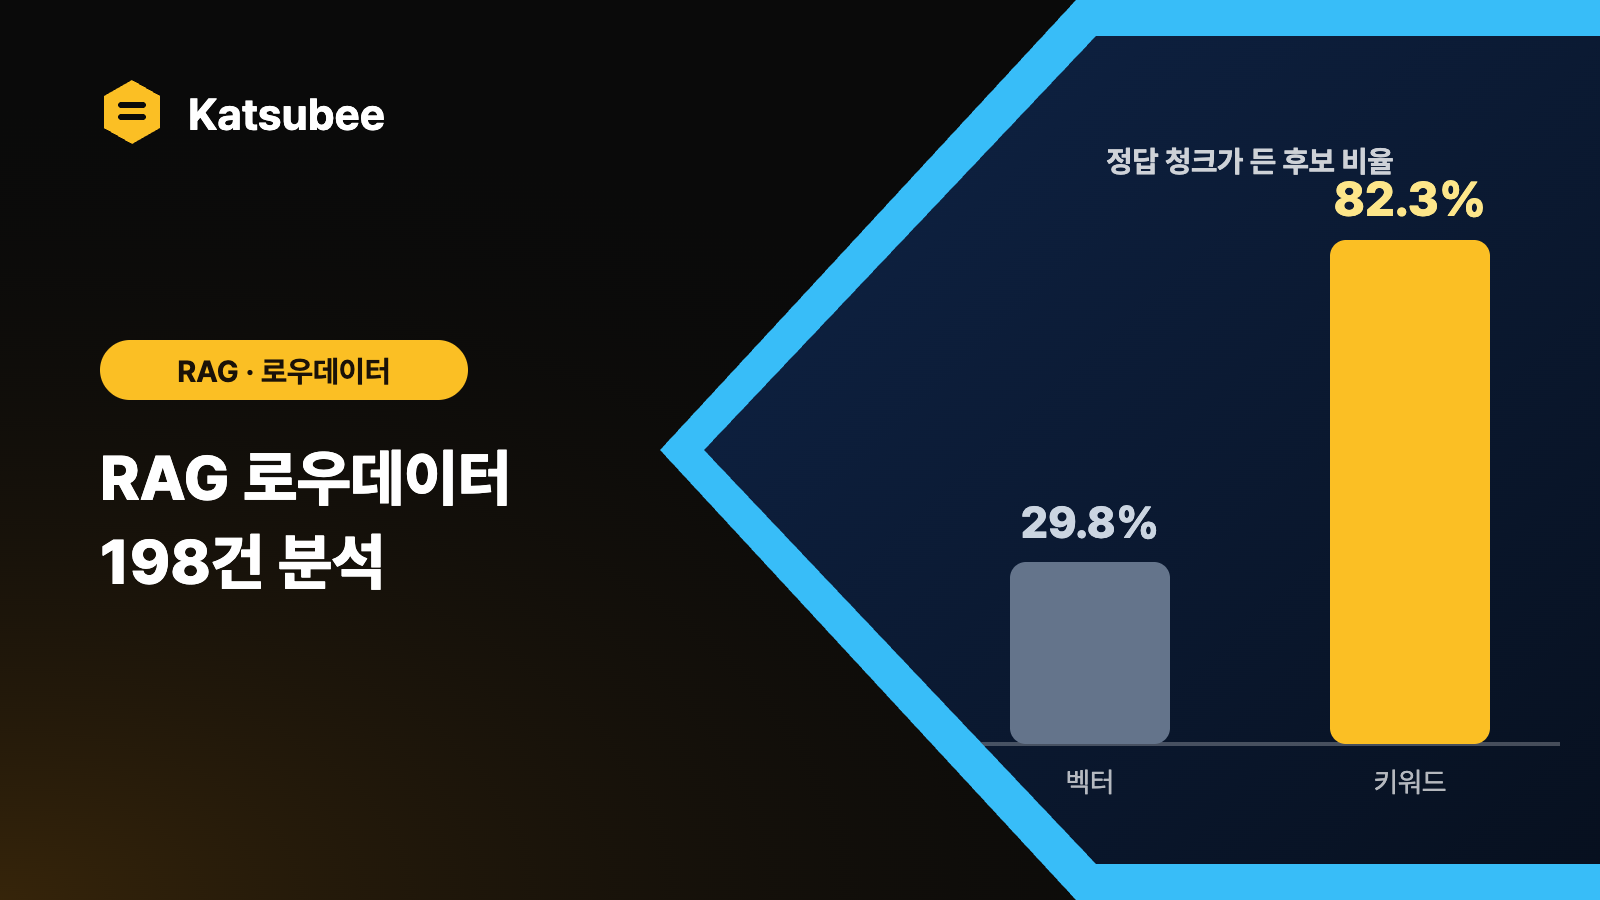
- katsubee는 매일 새벽 지식 청크로 질문을 만들어 실제 검색 경로를 통과시키고, 단계별 정답 순위를 남깁니다.
- 10월 12일부터 25일까지의 198건에서 정답은 키워드 후보 82.3%, 벡터 후보 29.8%에 들어 있었습니다.
- 후보에 정답이 없는 사례 26건, RRF 12개에서 잘린 사례 43건이 다음 손볼 지점으로 드러났습니다.
katsubee와 katsubox 소개 글에서 시작한 개선 시리즈의 다섯 번째 기록입니다. 앞선 글에서는 벤치마크 40문항으로 검색 결함을 고치고 리랭킹의 효과를 쟀습니다. 이번 글은 그 측정을 일회성으로 두지 않으려고 붙인 로우데이터 수집과, 거기서 나온 숫자를 다룹니다.
고정된 40문항이 남긴 한계
키워드 검색이 0건을 돌려주던 문제를 발견한 것도, 리랭킹의 이득을 숫자로 확인한 것도 40문항짜리 벤치마크 덕분이었습니다. 다만 이 세트는 한 번 만들어 둔 고정본입니다.
문서가 늘어나거나 모델을 교체했을 때 같은 수치가 유지되는지는 이 세트만으로 알 수 없습니다. 세트에 맞춰 검색을 조정하다 보면 세트에만 잘 맞는 검색기가 될 위험도 있습니다. 그래서 검색 품질 개선과 골든셋 생성의 재료가 될 데이터를 주기적으로 쌓는 수집 스케줄을 만들었습니다. 수집기는 사용자 대화를 읽지 않고 지식 문서 청크만 사용합니다.
수집기의 동작 순서
수집은 매일 새벽 03:30에 한 번 실행되고, 회차마다 질문 15개를 만듭니다. 청크를 고를 때는 지금까지 덜 쓰인 것부터 뽑습니다. 350자에 못 미치는 청크와 한글 비중이 낮은 표, 코드 청크는 건너뜁니다. 덕분에 문서 전체가 비교적 고르게 표본에 들어옵니다.
채팅 모델은 선택된 청크 하나만 읽고, 그 청크로 답할 수 있는 질문을 하나 만듭니다. 단락 속 문구를 그대로 옮기지 않고 일상어로 바꿔 묻도록 했고, 이 문서나 위 단락 같은 지시어는 쓰지 못하게 막았습니다.
이렇게 만든 질문을 실제 검색 경로에 넣으면 질문의 출처 청크가 곧 정답이 됩니다. 사람이 채점하지 않아도 단계별 순위를 얻는 방식입니다.
기록하는 항목
- 벡터, 키워드, RRF, 프롬프트에 쓰인 청크 각각에서의 정답 순위
- 정답 문서가 프롬프트에 쓰였는지 여부
- 검색에 걸린 시간
- 참고 자료만으로 만든 답변
결과는 DB 테이블과 날짜별 JSONL 파일에 함께 저장됩니다. 질문 하나가 실패해도 그 건만 넘기고 계속 진행합니다. 실행은 한 번에 하나씩 순차로 처리해서 채팅, GPU와 자원을 다투지 않도록 했습니다.
198건에서 확인한 후보 단계의 차이
10월 12일부터 25일까지 쌓인 표본은 198건입니다. 모델은 전부 gemma4:26b였고, 모든 표본이 리랭킹을 거친 상태로 기록됐습니다. 아래 수치는 이 198건을 직접 집계한 결과입니다.
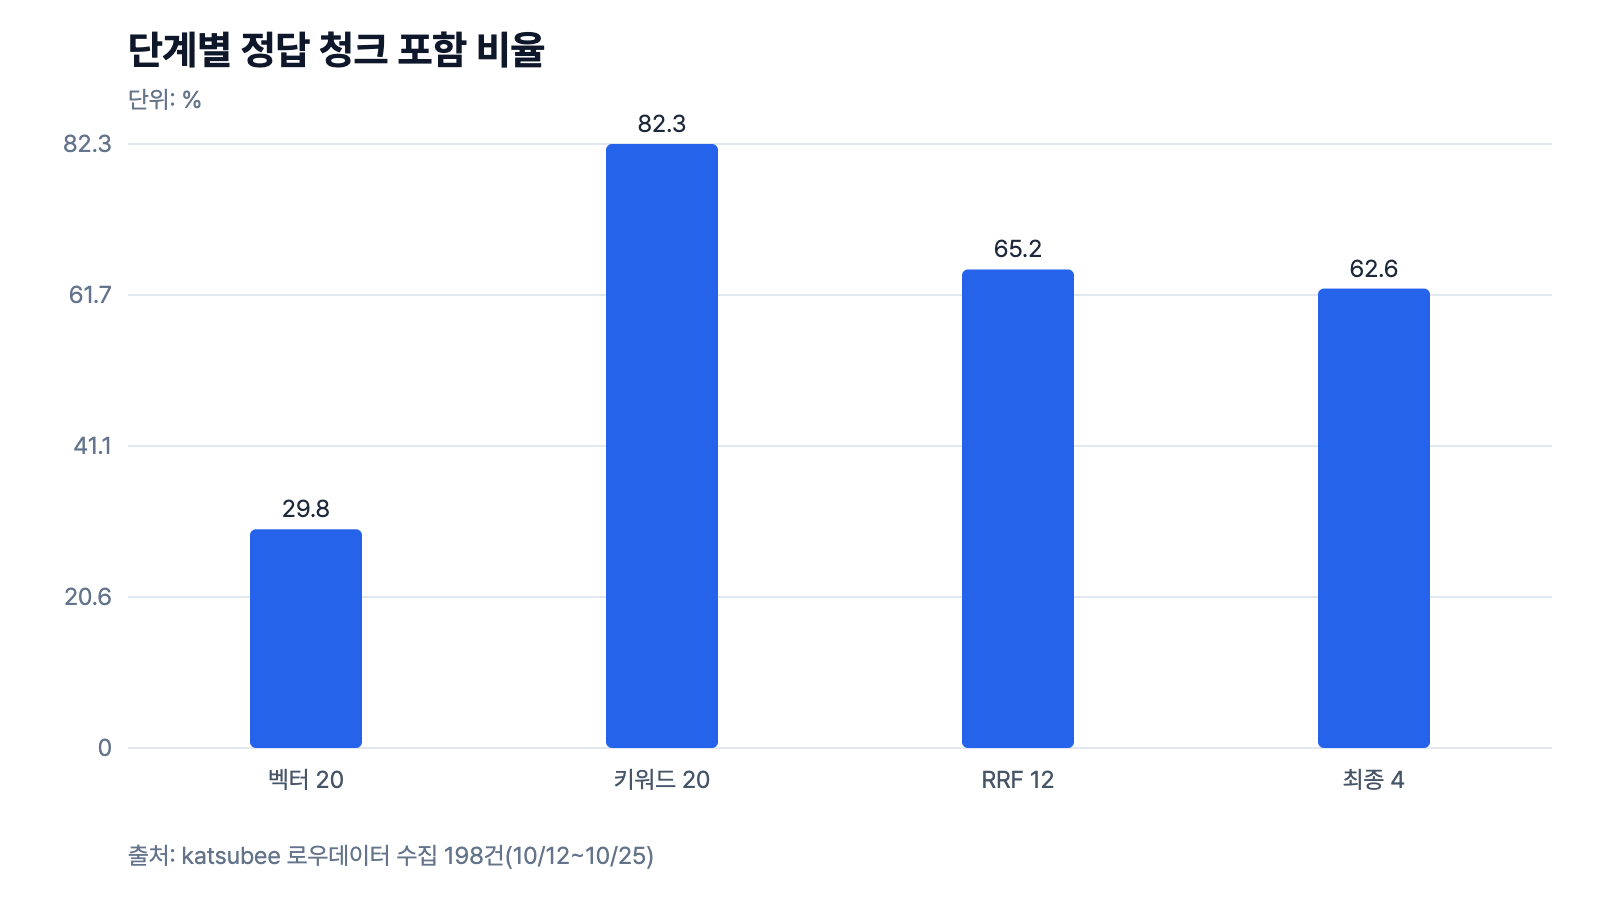
눈에 띄는 대목은 두 후보 경로의 격차입니다. 키워드 후보 20개 안에 정답이 있었던 비율은 82.3%(163건)였습니다. 벡터 후보 20개 안에서는 29.8%(59건)에 그쳤습니다. 키워드 검색을 OR와 접두 매칭 방식으로 고친 뒤, 하이브리드 검색이 실제로는 키워드 쪽이 끌고 가는 구조가 된 셈입니다.
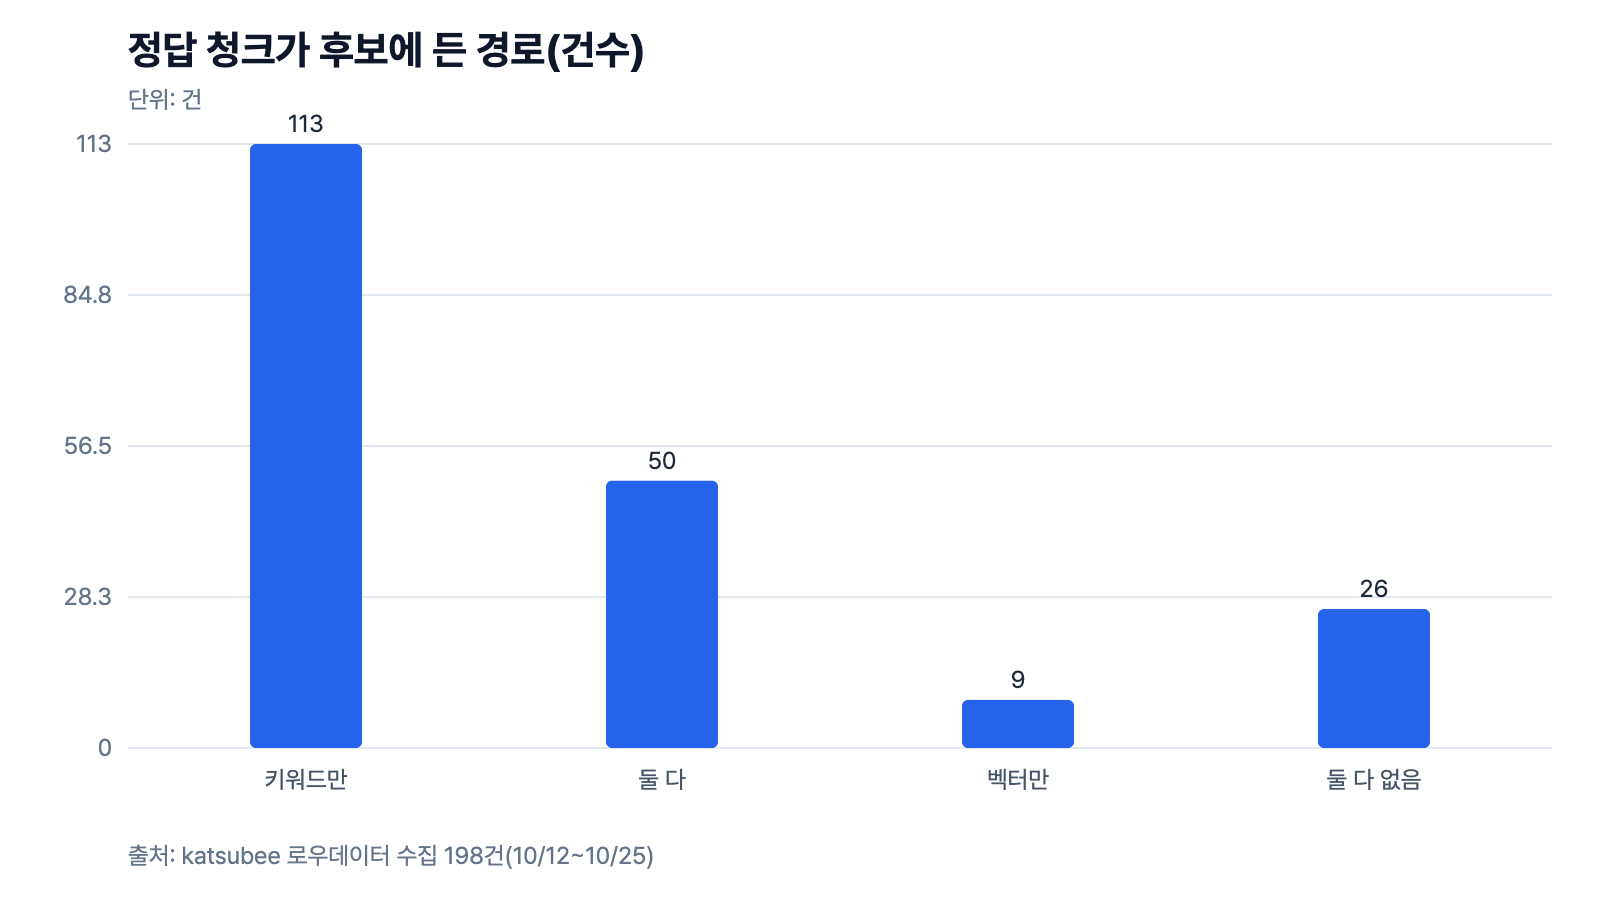
경로별로 쪼개 보면 키워드만 정답을 잡은 경우가 113건, 두 경로가 모두 잡은 경우가 50건, 벡터만 잡은 경우가 9건이었습니다. 어느 쪽도 정답을 후보에 올리지 못한 경우는 26건으로 전체의 13.1%입니다. 벡터의 몫은 작아 보이지만, 벡터만 정답을 찾아낸 9건이 있으니 걷어내도 되는 갈래라고 보기는 어렵습니다.
RRF에서 잘린 정답과 리랭킹이 건진 정답
후보 단계에서 정답을 잡았더라도 RRF로 12개까지 줄이는 동안 43건이 탈락했습니다. 정답이 RRF 12개 안에 든 비율은 65.2%(129건)이고, 최종 프롬프트에 들어간 4개 안에 든 비율은 62.6%(124건)입니다.
리랭킹이 얼마나 도왔는지도 따로 셀 수 있었습니다. RRF 순서를 그대로 썼다면 정답이 상위 4개에 드는 경우는 57건(28.8%)입니다. 리랭킹을 거치면 이 수가 124건으로 늘었습니다. RRF 5위에서 12위에 있던 정답 67건이 4개 안으로 올라왔습니다. 반대로 12개 안에 있던 정답이 밀려난 경우는 5건이었고, 원래 상위 4개에 있던 정답을 잃은 사례는 없었습니다.

정답 청크가 아니어도 정답 문서의 다른 청크가 프롬프트에 쓰인 경우까지 포함하면 193건(97.5%)입니다. 질문의 출처 청크 하나만 정답으로 인정하는 엄격한 잣대라서, 답변에 필요한 근거는 이보다 더 자주 들어갔다고 읽을 수 있습니다.
정확도에 붙는 지연 비용
검색 시간의 중앙값은 6.5초, 참고 자료 기반 답변은 3.9초였습니다. 검색 시간의 대부분은 리랭킹이 차지합니다. 이전 글에서 측정한 6.4초와 비슷한 수준이라, 정확도를 얻는 대신 지연을 내는 구조가 매일 같은 크기로 재확인되는 셈입니다.
수집이 비어 있던 하루
수집 파일은 10월 12일부터 25일까지 13개이고, 10월 23일 하루만 없습니다. 같은 날 새벽 04:00의 일반 질의 수집과 katsubox의 04:10 DB 백업도 비어 있었습니다. 서로 다른 서비스의 새벽 작업 세 개가 같은 날 함께 빠진 것입니다.
원인은 개별 작업의 버그가 아니고 Mac 전체가 꺼져 있었던 것입니다. 시스템 재부팅 기록을 보면 10월 23일 02:36에 종료돼 같은 날 20:38에 다시 켜졌고, 세 작업의 실행 시각이 모두 그 사이에 들어 있습니다. 종료된 이유는 확인하지 못했습니다.
로우데이터 수집은 하루가 빠져도 표본이 15건 줄어드는 정도입니다. 백업이라면 같은 공백이 훨씬 아픕니다.
숫자를 읽을 때의 편향과 다음 개선 대상
이 수치에는 편향이 있습니다.
질문을 LLM이 청크에서 직접 만들기 때문에 청크 안의 단어가 질문에 섞여 들어가고, 이는 키워드 검색에 유리하게 작용합니다. 실제 사용자는 문서에 없는 단어로 묻거나 모호하게 묻습니다. 같은 내용이 다른 청크에도 있으면 정답 청크를 놓쳐도 답은 맞을 수 있습니다. 수집 대상이 사용자 대화가 아니므로 실제 질문 분포도 담기지 않습니다.
그래도 다음에 손댈 곳은 분명해졌습니다.
- 정답이 후보에 없는 26건입니다. 어떤 문서와 청크에서 실패하는지 사람이 검수해 골든셋으로 옮기면 배포 게이트에 쓸 수 있습니다.
- RRF 12개에서 잘린 43건입니다. 후보 풀을 넓히면 리랭킹이 더 건질 수 있지만 지연도 함께 늘어납니다. 같은 수집 데이터로 실제 효과를 재 볼 계획입니다.
- 벡터 경로의 29.8%입니다. 임베딩을 바꾸면 얼마나 달라지는지 같은 질문으로 비교할 수 있게 됐습니다.