RAG 리랭킹 효과 측정: 검색 복구 전후 hit@4 비교와 지연 6.4초의 대가
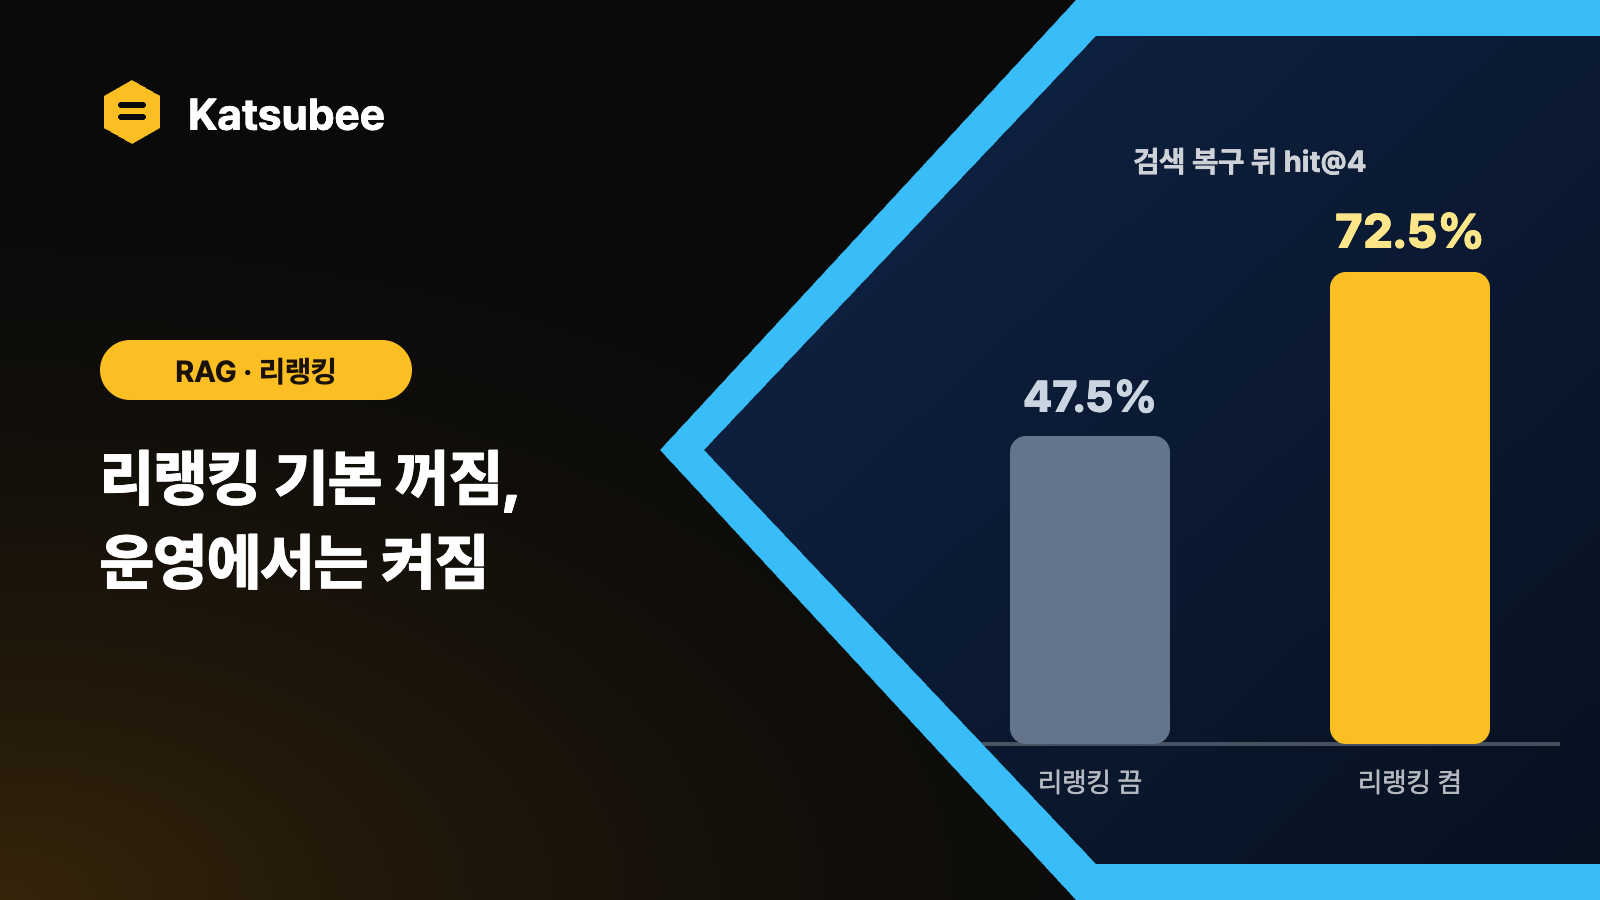
- 리랭킹은 코드 기본값이 꺼짐이고, 운영 설정값은 켜짐입니다.
- 키워드 검색이 고장 난 상태에서는 hit@4가 10%에서 15%로 올랐고, 복구 뒤에는 47.5%에서 72.5%로 올랐습니다.
- 질문당 6.4초가 더 걸려서 어드민에서 바로 켜고 끌 수 있는 토글로 남겼습니다.
katsubee·katsubox 소개 글, RAG 키워드 검색 복구 글에 이어 쓰는 시리즈 세 번째 기록입니다. 앞선 글이 후보를 제대로 뽑아 오는 작업이었다면, 이번 글은 이미 뽑힌 후보의 순서를 조정하는 리랭킹을 다룹니다. 효과가 거의 없던 첫 측정과, 검색을 고친 뒤 크게 달라진 두 번째 측정을 나란히 놓고 봅니다.
리랭킹 단계의 동작 방식
katsubee는 벡터 검색과 키워드 검색의 결과를 RRF로 합쳐 후보 목록을 만듭니다. 리랭킹은 이 목록을 채팅 모델에게 통째로 보여 주고, 질문에 도움이 되는 순서로 다시 배열하게 하는 단계입니다.
리랭킹을 켜면 상위 몇 개만 쓰지 않고 후보 12개를 가져와 모델에 넘깁니다. 모델이 골라 준 번호가 앞에 놓이고, 모델이 언급하지 않은 후보는 RRF 순서대로 뒤를 채웁니다.
크로스인코더 같은 별도 리랭커는 도입하지 않았습니다. 로컬 Ollama에 리랭커 모델이 없었고, 새 모델을 내려받는 대신 이미 쓰고 있는 채팅 모델로 해결하는 쪽을 택했습니다. 모델은 후보 번호를 JSON 배열로 돌려주는 listwise 방식으로 동작하므로, 질문 하나에 호출은 한 번입니다.
리랭킹이 실패해도 답변은 나가야 한다
이 단계는 답변을 만드는 경로 한가운데에 있습니다. 느려지거나 틀린 결과를 내더라도 답변 자체가 멈추면 안 됩니다. 그래서 지연 상한을 기본 4초로 두었습니다.
상한을 넘기거나, 호출이 실패하거나, 응답 형식이 깨지면 RRF 순서를 그대로 씁니다. 결과는 ok, timeout, error, unparsable 네 가지로 나누어 메트릭에 쌓습니다.
프롬프트에 넣은 규칙
프롬프트에는 순서를 정하는 기준도 적어 두었습니다. 질문이 묻는 핵심 사실을 직접 담은 후보가 먼저 오고, 폐지됐거나 구 규정이라고 밝힌 후보는 현재 기준을 묻는 질문에서 뒤로 밀립니다. 후보 본문에 이전 지시를 무시하라는 문장이 섞여 있어도 따르지 않고, 순서만 판단하도록 했습니다.
첫 측정은 기대에 못 미쳤다
지식 베이스는 문서 65개, 청크 430개입니다. 문서 청크에서 질문 40개를 만들고, 정답 청크가 상위 4개 안에 드는지를 hit@4로 확인했습니다.
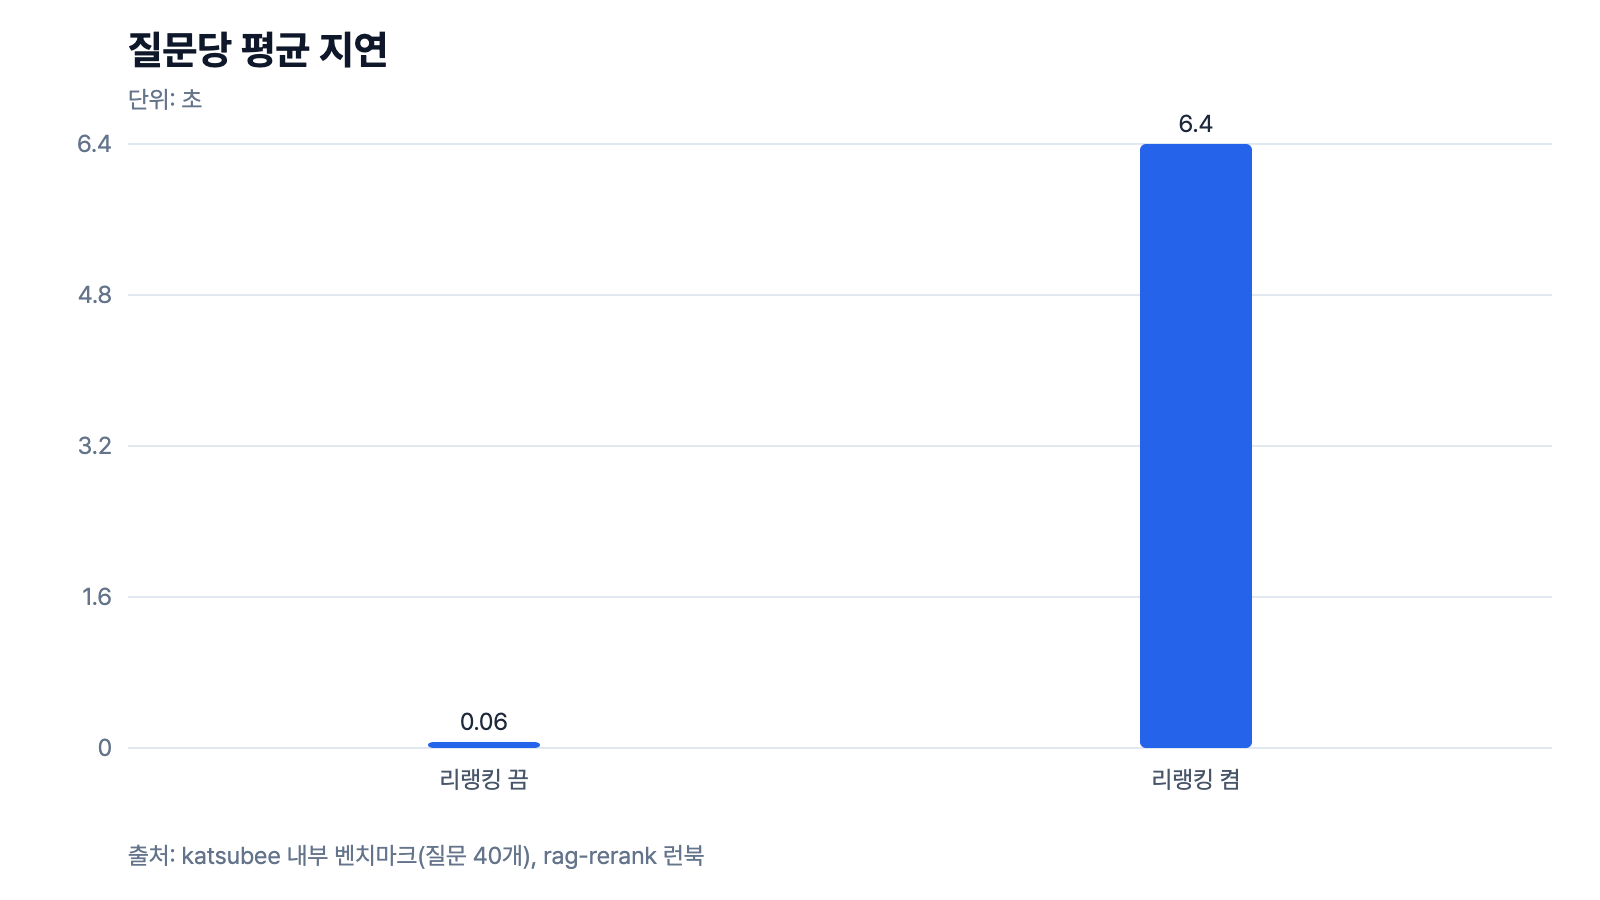
리랭킹을 끈 상태는 4/40, 즉 10%였습니다. 켜면 6/40, 15%였고, 질문당 지연은 62ms에서 6,278ms로 늘었습니다.
두 건 더 맞힌 결과를 효과라고 부르기는 어려웠습니다. 표본이 40개뿐이라 오차 범위 안에 들어가고, 6초 가까운 대기를 정당화하기에도 부족했습니다. 기본값은 꺼짐으로 두고, 효과가 작은 이유부터 찾기로 했습니다.
순서가 문제가 아니라 후보 풀이 비어 있었다
리랭킹이 바꿀 수 있는 것은 후보 안의 순서뿐입니다. 정답이 후보 12개에 들어오지 못하면 모델이 아무리 잘 판단해도 소용이 없습니다.
점검해 보니 키워드 검색이 자연어 질문에서 0건을 반환하고 있었습니다. 하이브리드 검색이라고 불렀지만 실제로는 벡터 검색 하나로 돌아가던 셈입니다. 원인과 수정 과정은 앞선 RAG 글에 적었습니다.
키워드 쪽을 OR 조합과 접두 매칭으로 고친 뒤 같은 벤치마크를 다시 돌렸습니다. 질문 세트를 새로 만들었기 때문에 첫 측정 값과 직접 맞대면 안 됩니다. 한 번의 실행 안에서 리랭킹 유무를 나란히 잰 값은 비교할 수 있습니다.
복구 뒤 재측정 결과
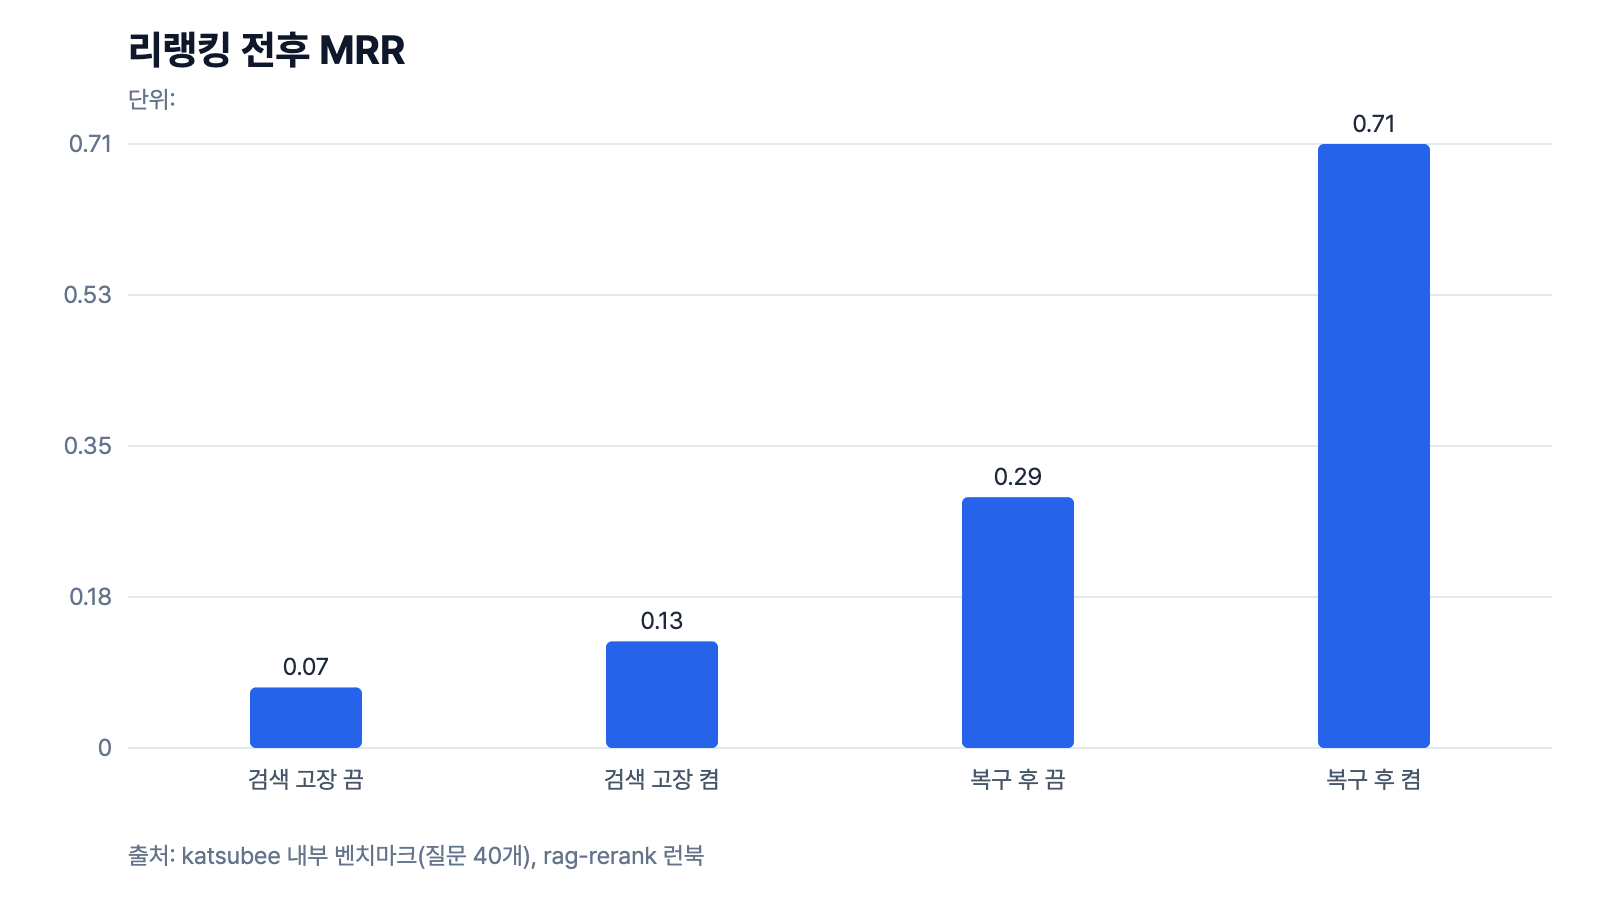
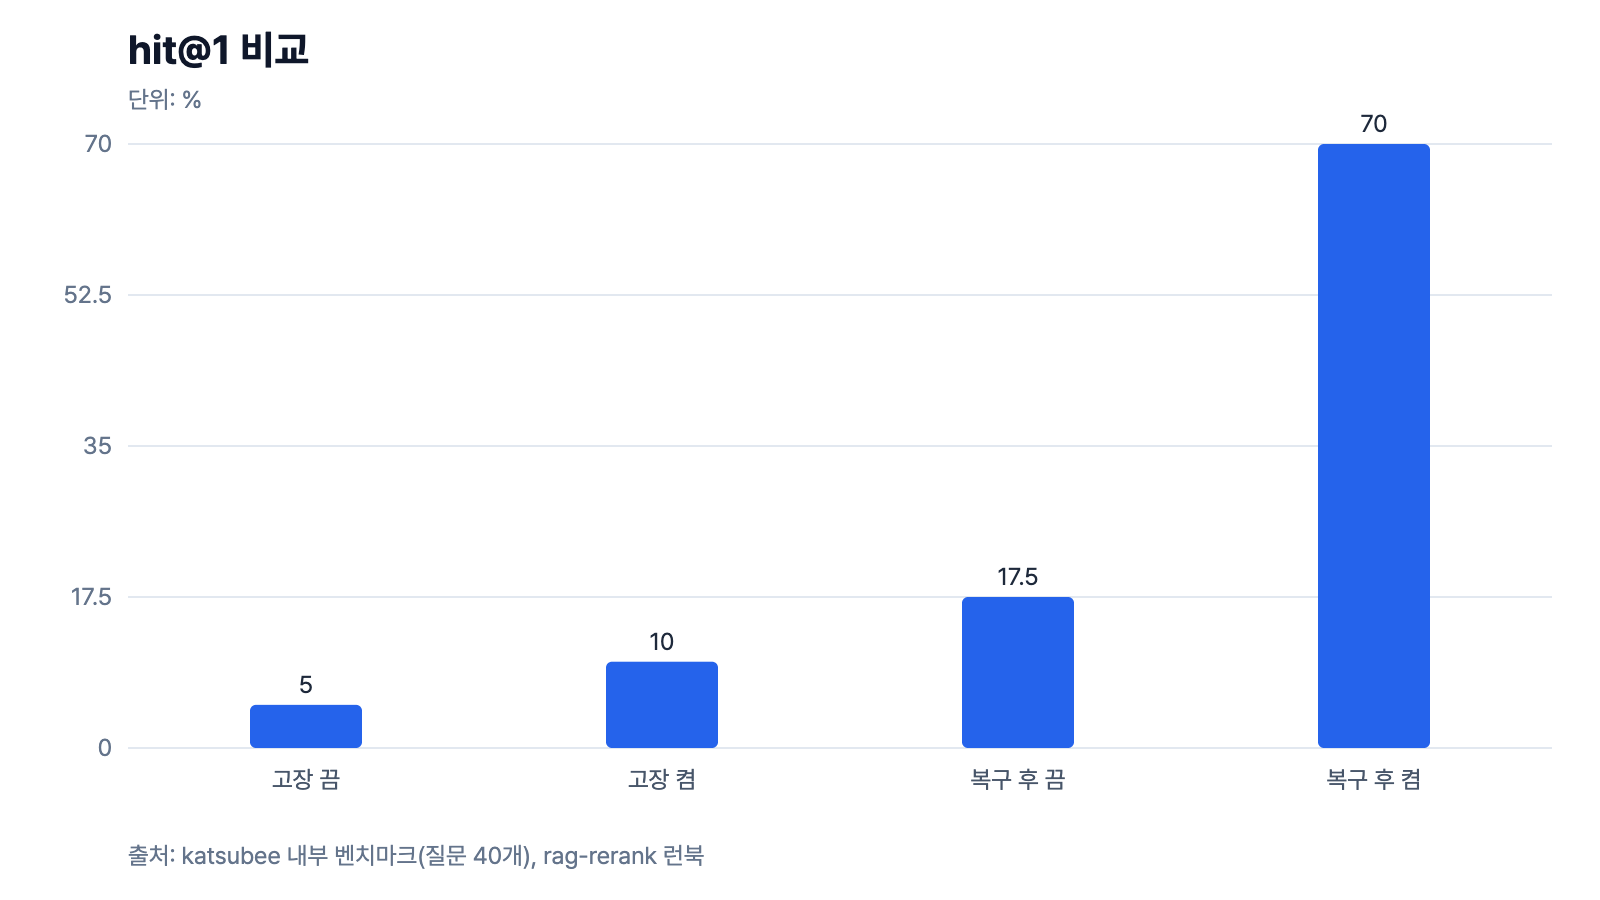
리랭킹 없이는 hit@4가 47.5%, hit@1이 17.5%, MRR이 0.294였습니다. 리랭킹을 켜자 hit@4는 72.5%, hit@1은 70.0%, MRR은 0.708로 올랐습니다. 정답이 후보 안에 있을 때 모델이 그것을 맨 앞자리로 끌어올린 경우가 많았다는 뜻입니다.
변화가 가장 큰 지표는 hit@1입니다. 17.5%에서 70.0%로 뛰었습니다. 리랭킹은 후보를 새로 찾는 도구로 보기 어렵고, 이미 들어온 후보 중 정답을 1등으로 올리는 도구라는 점이 수치로 확인됩니다.
후보 수와 스니펫 길이가 지연을 좌우한다
지연의 대부분은 모델이 후보를 읽는 시간입니다. 후보 풀은 기본 12개이고, 후보마다 앞 320자만 보여 줍니다.
후보를 늘리면 정답이 풀에 들어올 가능성이 커지는 대신 모델이 읽을 분량도 같이 늘어납니다. 줄이면 빨라지지만 정답이 풀 밖으로 밀려날 수 있습니다. 두 값 모두 설정으로 뺐습니다.
벤치마크는 기본값으로만 돌렸고 다른 조합은 아직 재지 못했습니다. 후보를 8개로 줄이면 지연이 얼마나 짧아지고 hit@4가 얼마나 빠지는지는 다음에 확인할 항목입니다.
모델의 일관성도 남은 숙제입니다. 같은 후보를 두 번 건네도 순서가 달라질 수 있어서, 이번 수치는 한 번의 실행 결과로 읽어야 합니다. 여러 번 반복해 분산을 보는 작업은 아직 하지 않았습니다.
6.4초를 어떻게 받아들일지
정확도를 얻는 대신 지연이 늘어납니다. 리랭킹을 끄면 질문당 64ms, 켜면 6.4초입니다. 채팅에서는 답변이 생성되기 전에 6초를 기다리는 셈이라, 모든 질문에 일괄 적용하기에는 부담이 큽니다.
코드의 기본값은 그래서 꺼짐으로 유지했습니다. 그런데 2026년 10월 25일에 운영 DB의 설정값 rag_rerank_enabled를 확인했더니 true였습니다. 지금 운영에서는 켜진 상태입니다. 언제, 어떤 이유로 켜졌는지는 설정값만으로는 알 수 없습니다.
어드민의 한도·설정 화면에서 지식 검색 리랭킹을 즉시 켜고 끌 수 있습니다. 켜 둔 채로 체감 지연과 rerank 소요 시간 메트릭을 보고 유지 여부를 정합니다. 지연이 부담스러우면 후보 수를 줄이거나 끕니다. 정확도가 중요한 환경에서만 쓰는 선택지로 남겨 둔 것입니다.
어떤 질문에 켜면 좋은가
리랭킹은 틀리면 곤란한 질문에 어울립니다. 개정 전후 규정처럼 구 규정과 현행 규정이 같이 올라가 있는 문서에서는, 낡은 후보를 뒤로 보내는 프롬프트 규칙이 도움이 됩니다. 가벼운 잡담이나 단순 조회에 6초를 쓸 이유는 없습니다.
수치를 읽을 때 주의할 점
코퍼스는 우리 저장소의 문서이고, 질문도 LLM이 문서 청크에서 만든 것입니다. 실제 사용자가 던지는 질문의 분포와는 다를 수밖에 없습니다. 문서에 없는 내용을 묻거나 모호하게 묻는 질문은 이 벤치마크에 들어 있지 않습니다. 표본이 40개라서 중간 지표는 흔들릴 수 있습니다.
다음 글에서는 정답 순위를 매일 자동으로 쌓는 검색 로우데이터 수집을 다룹니다. 질문 40개를 한 번 재는 방식에서 벗어나, 쌓이는 표본으로 검색 품질을 계속 확인하기 위한 장치입니다.