whisper.cpp 한국어 STT 사이드카 도입 검토: 모델 3종 CER 실측과 /stt-lab 제작 기록
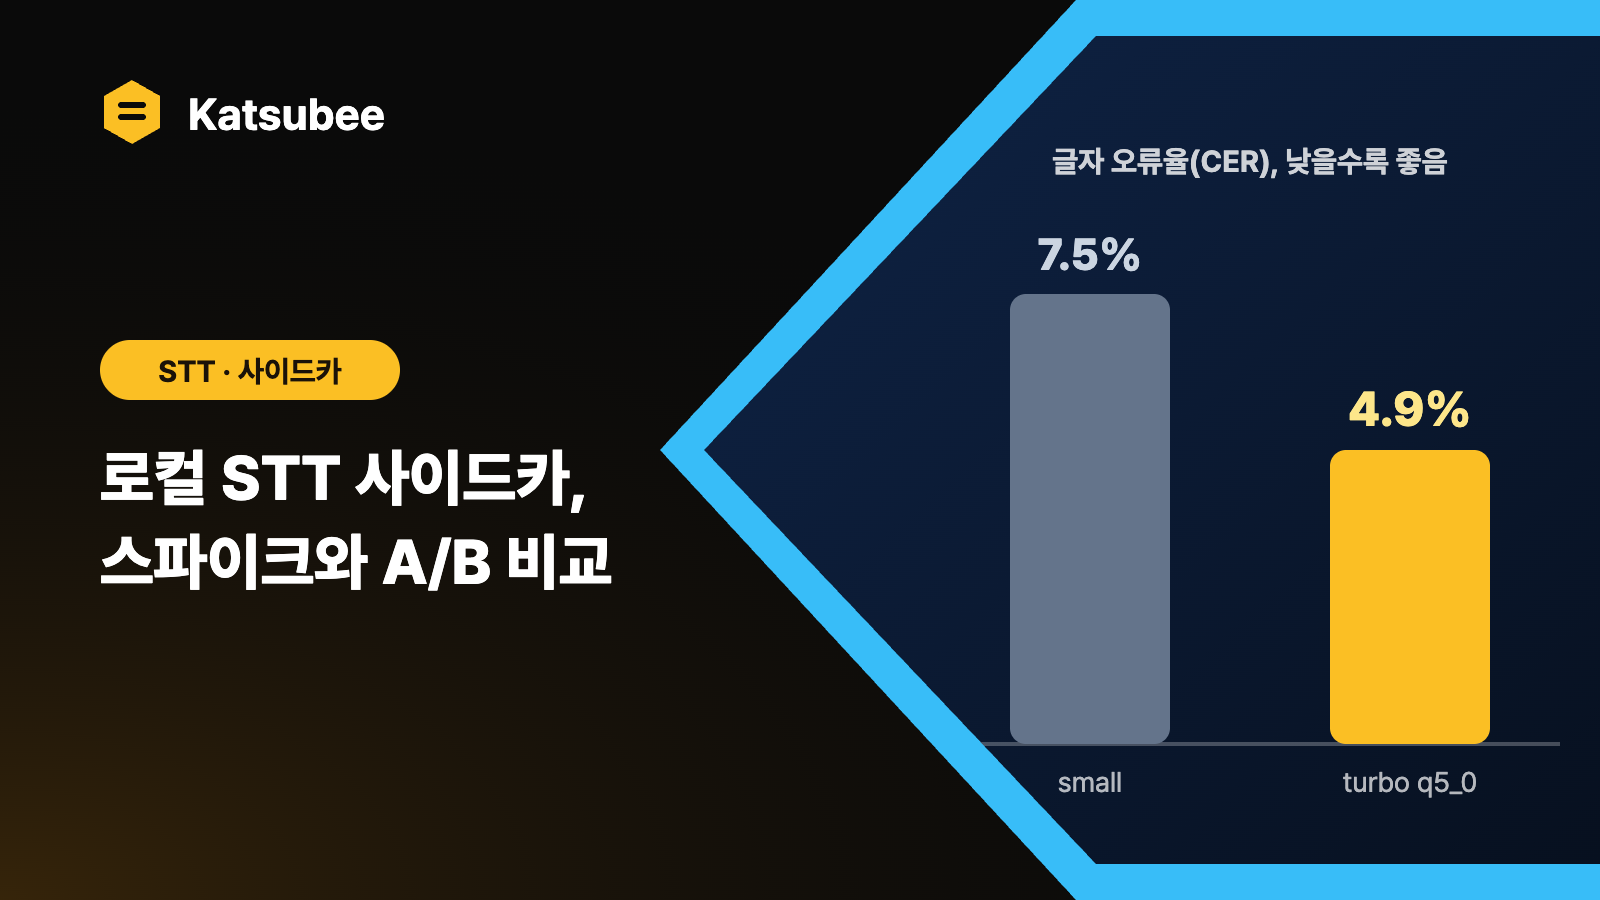
- TB-179에서 whisper.cpp 모델 3종을 한국어 합성 음성 120건으로 측정해 large-v3-turbo q5_0을 권고했습니다.
- TB-269에서는 사이드카, core 클라이언트, Spring 컨트롤러를 얇게 묶고 브라우저와 서버를 나란히 비교하는 /stt-lab을 만들었습니다.
- 측정에 쓴 음성이 합성이라 수치가 낙관적이며, 서버 STT가 브라우저보다 정확하다는 점은 아직 확인하지 못했습니다.
음성 입력을 브라우저 안에서만 처리하던 구조를 서버 쪽으로 옮겨도 되는지 판단하려고 이 작업을 시작했습니다. 먼저 TB-179에서 수치를 모았고, 그 수치를 바탕으로 TB-269에서 비교용 도구까지 구현했습니다. 아래는 두 작업의 기록입니다.
출발점: 브라우저 내장 인식에 기댄 입력 경로
기존 마이크 입력은 브라우저에 들어 있는 Web Speech STT가 맡았습니다. 응답을 소리로 읽어 주는 기능도 브라우저의 SpeechSynthesis에 의존하고 있었습니다.
문제는 브라우저마다 인식 엔진이 다르다는 점입니다. TB-179 문서를 보면 Chrome은 오디오를 Google 쪽으로 보내고, Safari는 기기 안에서 처리합니다. 서버에서 직접 인식하면 오디오가 외부로 나가지 않으므로 개인정보 측면에서 이득이 있습니다. 대신 호스트가 어느 정도의 부담을 지게 되는지가 결정의 기준이었습니다.
TB-179 스파이크: 합성 음성 120건으로 측정
측정 조건
TB-179는 구현을 하지 않고 실측 결과와 권고안만 남기는 스파이크입니다. 호스트에서 whisper.cpp 1.9.5를 Metal 백엔드로 실행했습니다. 입력은 한국어 30문장을 만들고 변형 4가지를 곱해 총 120건으로 구성했습니다. 변형은 깨끗한 원음, 음높이를 낮춘 음, 1.25배속, 분홍 잡음을 섞은 음입니다. 음성 자체는 macOS의 Yuna로 합성했습니다.
Yuna를 고른 데에는 사정이 있습니다. 한국어 음성 중 실제로 소리가 나온 것은 Yuna가 유일했고, 나머지 한국어 음성은 빈 오디오만 만들어 냈습니다.
지표와 결과
정확도는 글자 오류율(CER)로 비교했습니다. 공백과 구두점을 제거한 문자열의 편집거리를 참조 문장의 글자 수로 나눈 값입니다. 모델별 결과는 아래와 같습니다.
- ggml-small: CER 7.5%, 웜 p50 211 ms, 상주 메모리 752 MB
- large-v3-turbo q5_0: CER 4.9%, 웜 p50 658 ms, 상주 메모리 801 MB
- large-v3-turbo fp16: CER 4.9%, 웜 p50 617 ms, 상주 메모리 1869 MB
turbo의 두 변형은 오류율이 같았습니다. 그렇다면 메모리를 절반 이하로 쓰는 양자화 모델이 유리하므로 q5_0을 권고했습니다. small은 응답이 가장 빠르지만 오류율이 turbo의 1.5배 수준이었습니다.
남은 오류를 직접 열어 보니 상당수는 틀린 인식이 아니었습니다. PostgreSQL, API, 325,000원처럼 표기 방식이 참조 문장과 달라서 생긴 차이였습니다. 정말로 잘못 들은 사례는 국숫집이 국숲집으로, 아홉 시가 마홉시로 나온 정도의 소수였습니다.
로컬 TTS는 보류
읽어주기 쪽도 같이 확인했습니다. Yuna는 호출 한 번에 대략 575~600 ms가 걸렸고, 생성한 음성을 다시 인식시켜 잰 CER은 5.0%였습니다. 다만 쓸 수 있는 한국어 음성이 하나뿐이고, 자연스러운지는 사람 귀로 판단하지 못했습니다.
piper의 ko_KR-kss-medium은 이 호스트에서 모델 로드부터 실패했습니다. macOS arm64용 wheel에 espeak 데이터 경로가 빌드할 때의 값으로 고정되어 있어서 phontab 파일을 찾지 못했습니다. 경로를 따로 지정해 봐도 달라지지 않았고, 결국 서버 TTS는 보류하기로 했습니다.
TB-269 구현: 세 겹으로 쌓은 얇은 프록시
구조는 단순합니다. 맨 아래에는 scripts/run-stt-sidecar.sh가 띄우는 whisper-server가 있습니다. 그 위의 core에서는 SttClient가 /inference 엔드포인트로 오디오를 멀티파트 업로드합니다. 가장 바깥에는 Spring 컨트롤러가 POST /api/v1/stt를 열어 둡니다.
exec whisper-server --host "$HOST" --port "$PORT" \
 -m "$MODEL" -l "$LANGUAGE" -t "$THREADS" --convert -nt
이 명령에서 눈여겨볼 옵션은 --convert입니다. 브라우저가 MediaRecorder로 녹음한 webm이나 mp4를 ffmpeg를 거쳐 16 kHz wav로 바꿔 주기 때문에, 서버가 따로 변환 코드를 가질 필요가 없습니다.
사이드카에는 인증이 없습니다. 그래서 스크립트는 STT_HOST가 로컬 주소가 아니면 기동을 거부합니다. 모델 파일이 없을 때도 기동하지 않게 해 두었는데, launchd가 처음 띄울 때 모델 다운로드에 걸려 멈추는 일을 막기 위해서입니다.
컨트롤러의 안전장치
컨트롤러에는 몇 겹의 제한을 걸었습니다.
- 로그인한 사용자만 호출할 수 있습니다.
- 업로드 크기는 8 MiB까지 허용합니다.
- 사용자별로 분당 30건의 레이트리밋이 적용됩니다.
- 호스트 스왑 가드레일(TB-151)을 통과해야 합니다.
- 받은 오디오는 저장하지 않습니다.
이미지나 음악 생성에는 HostGenerationGate로 요청을 직렬화하지만, STT에는 쓰지 않았습니다. 상주 메모리가 0.8 GB 수준이고 요청 하나에 0.6초 안팎이라 다른 작업과의 간섭이 작다고 TB-179에서 판단했기 때문입니다. 이 판단은 실제 사용 중에 잰 값이 아니라 스파이크 수치에서 나온 것임을 밝혀 둡니다.
꺼져 있어도 기존 경로는 그대로
baseUrl 설정이 비어 있으면 기능 전체가 비활성화되고 API는 503을 반환합니다. 프런트는 이 응답을 받으면 브라우저 인식으로 되돌아갑니다. 기본값이 꺼짐 상태라서 사이드카가 내려가도 기존 음성 입력은 영향을 받지 않습니다.
/stt-lab: 두 엔진을 같은 발화로 비교
원래 만들고 싶었던 것은 푸시투토크 같은 기능이 아니라 비교 수단이었습니다. /stt-lab 페이지는 한 번의 발화를 브라우저 Web Speech와 서버 STT가 동시에 받아 적도록 합니다. 말하려던 문장을 참조 텍스트로 입력해 두면 두 엔진 각각의 CER과 지연 시간이 계산됩니다.
프런트의 stt-compare.ts는 스파이크와 동일한 정의로 CER을 구합니다. 엔진 오류로 텍스트가 비어 있으면 그 엔진의 CER은 1로 처리합니다. 시도마다 승패와 무승부를 집계하며, 전체 결과는 JSON으로 복사할 수 있습니다.
배포 후 확인한 내용
todo 기록에는 core 단위 테스트 10건과 프런트 테스트 8건이 남아 있습니다. 호스트 설치와 배포는 2026-10-23에 끝났습니다.
배포 직후에는 /stt-lab이 404를 반환했습니다. 정적 페이지 라우트가 등록되어 있지 않았던 것이 원인이어서, 라우트를 등록하는 수정을 별도로 병합했습니다. 로드맵의 STT 카드에는 TB-269가 미배포로 적혀 있었는데, 이것도 TB-277로 고쳤습니다. 이제 운영 상태와 문서가 일치합니다.
아직 입증하지 못한 부분
서버 STT가 브라우저보다 정확하다고 말할 근거는 없습니다. 스파이크는 합성 음성으로 진행했기 때문에 실제 발화에 섞이는 말버릇, 방의 울림, 기기 잡음보다 쉬운 조건입니다. 표기 차이를 보정하지 않은 원시 CER이라는 점도 감안해야 합니다.
채팅 추론이 동시에 돌 때의 간섭, 30초를 넘는 긴 발화, 스트리밍 지연은 측정 대상에 넣지 못했습니다. 푸시투토크와 설정 화면의 엔진 선택 기능은 비교 결과가 나온 뒤로 미뤄 둔 상태입니다.
다음 단계는 /stt-lab에서 제 실제 목소리로 여러 문장을 비교해 보는 것입니다. 그 결과를 보고 본 기능을 만들지 정할 계획입니다.